Kandinsky Avatar 1.0 — бесплатная модель Сбера с открытым кодом, вышедшая 3 ноября 2026 года. По фотографии, записи речи и короткому описанию сцены она делает видео, где человек со снимка говорит: губы двигаются в такт речи, есть мимика и жесты. Голос модель не создаёт, запись нужна ваша. Попробовать модель без установки можно в демо на Hugging Face, сайте, куда разработчики выкладывают нейросети. Генерация там запускается только после входа в аккаунт: бесплатный аккаунт даёт примерно один 5-секундный ролик в сутки, подписка PRO за $9 (≈740 ₽) в месяц — около 12. Полная версия на своём компьютере требует видеокарту NVIDIA с 48 ГБ памяти.
Kandinsky Avatar 1.0 — нейросеть Сбера, которая превращает фотографию и запись голоса в видео: человек на снимке произносит ваш текст, двигает губами в такт речи, поворачивает голову и жестикулирует. Модель вышла 3 ноября 2026 года. Она бесплатная, а код и сама модель выложены в открытый доступ: скачать их может кто угодно, в том числе для рекламы и платных роликов.
Попробовать без установки можно в демо на Hugging Face — это сайт, куда разработчики выкладывают нейросети. Мы проверили его 4 ноября: без входа в аккаунт ролик не делается, с бесплатным аккаунтом получится примерно один 5-секундный ролик в сутки. Дальше расскажем, что подготовить и когда проще взять другой сервис.
Что такое Kandinsky Avatar и что он умеет
Kandinsky Avatar 1.0 — набор моделей Сбера для говорящих видеоаватаров, построенный на видеомодели Kandinsky 5.0 Video. Модели нужны три вещи: фото, запись речи и пара слов о сцене. Из них получается ролик, где персонаж с картинки произносит записанный текст.
По данным Сбера, модель синхронизирует губы с речью и сама добавляет мимику, повороты головы и жесты. Эмоцию можно задать текстом, например радость или грусть. Заговорить могут люди, животные и мультяшные персонажи. В инструкции на GitHub уточняют, что в кадре двигается вся фигура.
Голос модель не синтезирует и не клонирует. Она работает только с той записью, которую вы загрузили, и говорит на её языке. Обучали модель на более чем миллионе фрагментов интервью, выступлений и подкастов на 95 языках, среди них русский, английский и казахский.
В сети модель встречается под двумя названиями. Сбер в пресс-релизе зовёт её Kandinsky Avatar 1.0, а на GitHub и Hugging Face она лежит как Kandinsky S2V 1.0 (speech to video, «речь в видео»). Это одна и та же модель.
Сбер выпустил две версии, у каждой есть ускоренный вариант:
| Версия | Размер | Чёткость | Где запускать |
|---|---|---|---|
| Lite | меньше и быстрее (2 млрд параметров) | обычная | демо на Hugging Face или своя видеокарта от 48 ГБ |
| Pro | больше и качественнее (21 млрд параметров) | высокая | только своя или арендованная видеокарта от 48 ГБ, для высокой чёткости — 80 ГБ |
Длина ролика, по словам Сбера, — до минуты. Как выглядит результат, видно в примерах на странице проекта. В демо работает Lite, поэтому чёткость там ниже, чем в роликах Pro.
Где попробовать Kandinsky Avatar бесплатно
Самый простой путь — официальное демо на Hugging Face по адресу huggingface.co/spaces/kandinskylab/Kandinsky-S2V-1.0-Demo. Оно открывается в браузере на компьютере и телефоне, ничего ставить не нужно. В демо работает облегчённая ускоренная версия Lite, а из записи берутся только первые 5 или 10 секунд.
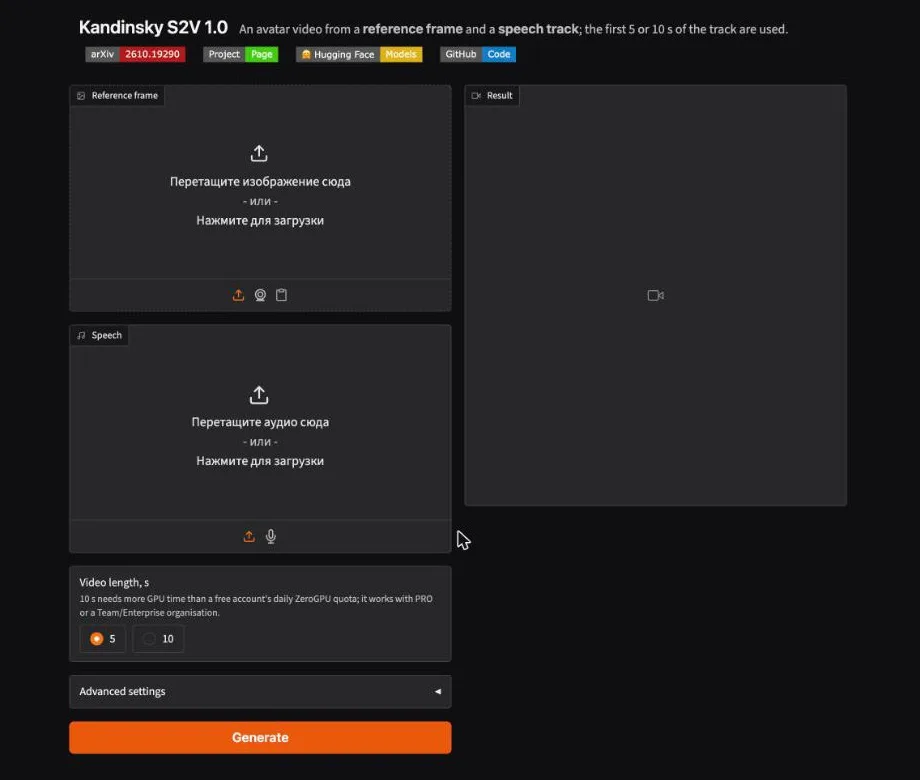
Главное ограничение — время видеокарты. Демо работает на общих серверах ZeroGPU, где у каждого посетителя есть суточная квота. Пятисекундный ролик в этом демо забирает до 200 секунд квоты, десятисекундный — до 360.
| Кто вы на Hugging Face | Квота в сутки | Что получится в демо |
|---|---|---|
| Без входа | 2 минуты | ничего: генерация не запускается |
| Бесплатный аккаунт | 5 минут | примерно один ролик на 5 секунд |
| PRO за $9 (≈740 ₽) в месяц | 40 минут | около 12 роликов по 5 секунд или ролики по 10 секунд |
Расчёт наш: квоты взяты из справки Hugging Face, расход — из кода демо. Квота обновляется через сутки после первой генерации. Владельцы PRO могут докупить время сверх квоты, $1 (≈82 ₽) за 10 минут. Цены и курс ЦБ — на 4 ноября 2026 года.
Без входа демо выглядит рабочим: фото и запись загружаются, кнопка нажимается. Но после нажатия вместо ролика появляется ошибка «The requested GPU duration (200s) is larger than the maximum allowed», то есть запрошенное время видеокарты больше разрешённого. Мы получили её 4 ноября 2026 года. Войдите в аккаунт Hugging Face до загрузки файлов.
Регистрация на Hugging Face бесплатная, по электронной почте. Сбер ID для неё не нужен, в отличие от ГигаЧата, где работает обычный Kandinsky для картинок и видео. Сбер обещает добавить Kandinsky Avatar и в свои сервисы, но сроков не назвал.
Как сделать говорящий аватар по фото: пошагово
Войдите на Hugging Face, загрузите портрет и запись речи, выберите 5 секунд и нажмите Generate. Больше всего времени уходит на подготовку фото и записи.
Войдите на Hugging Face
- Зарегистрируйтесь на huggingface.co по почте и подтвердите адрес.
- Откройте демо уже после входа, иначе квоты не хватит.
Загрузите фото в поле Reference frame
- Портрет анфас, лицо крупно и хорошо освещено, рот закрыт.
- Пропорции кадра модель сохранит, вертикальное фото даст вертикальный ролик.
Загрузите запись в поле Speech
- Чистая речь без музыки, главная фраза должна прозвучать в первые 5 секунд.
- Можно записать на диктофон телефона прямо в демо, кнопкой с микрофоном.
Выберите 5 секунд и опишите сцену
- 10 секунд доступны только с PRO.
- В Advanced settings, в поле Prompt, допишите эмоцию и движения, пример промта ниже.
Нажмите Generate и скачайте ролик
- Готовое видео появится справа, в окне Result.
- Не понравилось — смените число в поле Seed, это даст другой вариант движений.
Промт лучше писать по-английски: демо добавит его к своему стандартному описанию. Мы советуем уложиться в одну-две фразы:
A friendly woman speaks directly to the camera with a warm smile, calm natural head movements, small hand gestures, soft daylight, static camera
Перевод: дружелюбная женщина говорит прямо в камеру с тёплой улыбкой, спокойные движения головы, небольшие жесты руками, мягкий дневной свет, камера неподвижна. Для грустного или серьёзного тона замените «warm smile» на «serious expression».
Какое фото и какая запись подходят
Лучше всего срабатывает портрет, где лицо занимает заметную часть кадра. На странице проекта разработчики признают: если лицо в кадре мелкое, губы хуже попадают в слова. Подойдёт снимок по плечи или по пояс, взгляд в камеру, ровный свет без резких теней на лице.
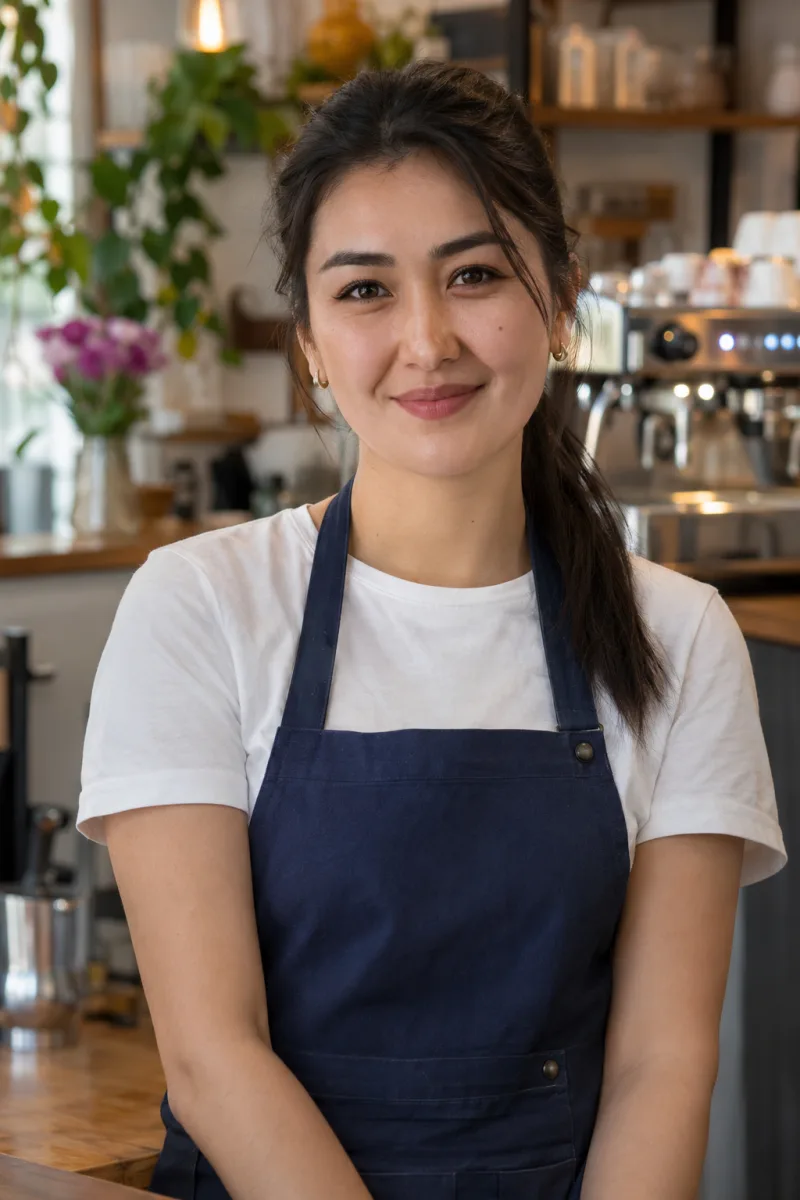
Этот портрет мы сгенерировали в ChatGPT специально для проверки, реального человека на нём нет. Для бизнеса это удобный вариант: вымышленного персонажа не нужно уговаривать сниматься и не нужно брать с него согласие.
Подойдёт голос с диктофона телефона, записанный в тихой комнате. Если своим голосом говорить не хочется, текст можно озвучить синтезатором речи. Мы для проверки взяли встроенный голос «Милена» на Mac: команда say в Терминале сохраняет речь в файл. Мы советуем брать запись без фоновой музыки и шума: модель двигает губы под звук дорожки, и посторонние звуки ей мешают.
Даст плохой ролик
- групповое фото или лицо мелко на заднем плане
- профиль, тёмные очки, рука у лица
- речь под музыку или в шумном кафе
- главная фраза начинается на седьмой секунде
Даст хороший ролик
- портрет анфас по плечи или по пояс
- лицо освещено, рот закрыт
- чистая речь в тихой комнате
- главная фраза в первые 5 секунд
Можно ли запустить Kandinsky Avatar на своём компьютере
Можно, если у вас есть видеокарта NVIDIA с 48 ГБ памяти и больше, а для HD-роликов Pro — 80 ГБ. Так сказано в инструкции на GitHub. Специальный режим экономии (vae_tiling) снижает расход памяти примерно до 28 ГБ ценой едва заметных швов на картинке.
Сбер в пресс-релизе пишет, что Lite запускается «на домашней видеокарте». На практике это верно только для дорогих профессиональных видеокарт: у массовых игровых карт памяти обычно 8-16 ГБ, этого не хватит. Файлы модели занимают около 25 ГБ для Lite и около 65 ГБ для Pro. Нужен драйвер NVIDIA версии 580 или новее.
Скорость на серверной видеокарте H100, по замерам разработчиков, такая: ускоренная Lite считает одну секунду видео за 8,7 секунды, полная Pro в HD — почти 13 минут. Минутный ролик в высоком качестве на одной видеокарте займёт полдня.
Для владельца кофейни или магазина этот путь почти никогда не нужен. Он для тех, кто встраивает аватары в свой сервис: файлы модели можно скачать с Hugging Face, а лицензия MIT разрешает использовать их в платном продукте. Diffusers, популярная библиотека для разработчиков, уже умеет запускать модель, но только в свежей версии с GitHub: официального выпуска пока нет. Подключение к ComfyUI, программе для сборки генераций из блоков, Сбер обещает, но готовой интеграции на GitHub пока нет.
Kandinsky Avatar или HeyGen: что выбрать
Для одной короткой фразы бесплатно хватит Kandinsky Avatar в демо, для регулярных минутных роликов с озвучкой текста удобнее HeyGen. HeyGen сам озвучивает текст выбранным голосом и даёт ролики до минуты в удобном кабинете, Kandinsky Avatar в демо даёт 5 секунд и требует готовую запись голоса.
| Kandinsky Avatar (демо) | HeyGen | |
|---|---|---|
| Бесплатно | около 1 ролика на 5 секунд в сутки | 3 видео в месяц с водяным знаком |
| Платно | PRO Hugging Face $9 (≈740 ₽) в месяц | Creator $29 (≈2 370 ₽) в месяц |
| Голос | только ваша запись | сам озвучивает текст |
| Длина в браузере | 5 секунд, с PRO 10 | до минуты на бесплатном тарифе |
В слепом сравнении Сбера ролики Pro-версии предпочли роликам HeyGen IV в 54% случаев, Kling Avatar 2 — в 63%. Тест проводил сам Сбер, а 54 против 46 — почти поровну. Подробнее про HeyGen и другие способы — в нашем гайде как оживить фото нейросетью.
Как собрать из коротких фрагментов ролик для рилсов и сторис, мы разобрали отдельно. А если вы строите свой сервис с аватарами, ставьте Kandinsky Avatar на свою видеокарту: лицензия MIT это разрешает.
Для чего говорящий аватар пригодится бизнесу
Сбер предлагает делать на модели видеоконсультантов, виртуальных преподавателей и ведущих для блогов. Малому бизнесу в СНГ ближе короткие форматы:
- приветствие на сайте или в Instagram от владельца или персонажа бренда;
- объявление об акции или открытии, как фраза нашей бариста «первая чашка в подарок»;
- один и тот же ролик на русском и казахском: модель говорит на языке записи, достаточно двух озвучек;
- поздравление клиентов с праздником без съёмочного дня.
Пятисекундного ролика хватает на одну фразу, поэтому в демо удобно делать начало рилса, которое цепляет зрителя, а остальное собирать в видеоредакторе.
Бесплатный мастер-класс · онлайнХотите делать такие ролики сами? На вебинаре показываем, как собрать видео для бизнеса с нейросетями без съёмочной группы.
Записаться бесплатно →Чего Kandinsky Avatar пока не умеет
В демо ролик длится максимум 10 секунд. Голос и перевод модель тоже не делает: текст нужно озвучить заранее. Ролик делается фрагментами по 5 секунд, и на странице проекта разработчики признают, что в длинных роликах персонаж может повторять одни и те же позы.
Есть и правовая граница. Модель анимирует человека по одной фотографии, а голос может принадлежать кому угодно, поэтому разработчики просят использовать только снимки людей, давших согласие, и не выдавать результат за настоящую запись. Фото сотрудника берите с его письменного согласия, фото знаменитостей и чужих людей не используйте вовсе. Другие бесплатные нейросети для картинок, текстов и видео мы собрали в отдельной подборке.
Частые вопросы
Kandinsky Avatar бесплатный?
Да. Код и модели выложены под лицензией MIT, их можно бесплатно скачать и использовать даже в коммерческих проектах. Платить приходится за работу видеокарты: демо на Hugging Face бесплатно даёт примерно один 5-секундный ролик в сутки, больше — с подпиской PRO за $9 (≈740 ₽) в месяц или на своей видеокарте.
Можно ли сделать говорящий аватар без регистрации?
В демо Kandinsky Avatar нет. Мы проверили 4 ноября 2026 года: без входа на Hugging Face генерация останавливается с ошибкой, потому что пятисекундный ролик требует 200 секунд времени видеокарты, а гостю дают меньше. Регистрация на Hugging Face бесплатная, по электронной почте, Сбер ID для неё не нужен.
Kandinsky Avatar говорит по-казахски или по-узбекски?
Модель говорит на языке той записи, которую вы загрузили: она двигает губы под вашу речь и не переводит её. По данным Сбера, её обучали на видео на 95 языках, включая русский, английский и казахский. Узбекский в пресс-релизе не назван, поэтому для узбекской речи сначала проверьте синхронность губ на коротком ролике.
Чем Kandinsky Avatar отличается от HeyGen?
HeyGen — готовый сервис: загрузили фото, вписали текст, выбрали голос, и ролик готов. Kandinsky Avatar — модель с открытым кодом, которая не озвучивает текст сама и не даёт удобного кабинета, зато бесплатная. В слепом тесте Сбера ролики Pro-версии предпочли роликам HeyGen IV в 54% сравнений, но тест проводил сам Сбер, а в демо работает облегчённая Lite.
Можно ли сделать говорящее фото чужого человека?
Только с его согласия. Авторы модели прямо просят анимировать лишь тех, кто разрешил это сделать, и не выдавать ролик за настоящую запись. Для бизнеса надёжнее взять письменное согласие сотрудника или использовать вымышленного персонажа, сгенерированного нейросетью, как в нашем примере.
Источники
- GitHub: kandinskylab/kandinsky-s2v (код и инструкция)
- Hugging Face: демо Kandinsky S2V 1.0
- Hugging Face: модель Kandinsky-S2V-1.0-Lite
- Страница проекта Kandinsky S2V 1.0
- Hugging Face: квоты ZeroGPU
- Hugging Face: тарифы
- Cossa: Сбер выпустил Kandinsky Avatar 1.0
- RB.ru: Сбер открыл доступ к Kandinsky Avatar 1.0
- vc.ru: Kandinsky Avatar 1.0 от Сбера
- Курс ЦБ РФ на 04.11.2026 (зеркало cbr-xml-daily)
Пишет о нейросетях и продвижении в них для предпринимателей и маркетологов. Каждый гайд проверяет руками, цены сверяет по официальным страницам.