LLM, или большая языковая модель, — нейросеть, которую обучили на огромном объёме текстов. Нейросеть — понятие шире: так называют программу из множества простых связанных вычислений, которая учится на примерах. LLM собирает ответ по кусочку слова, каждый раз выбирая одно из самых вероятных продолжений, и с базой фактов не сверяется, поэтому может уверенно ошибаться. На LLM работают ChatGPT, Claude, Gemini, DeepSeek и Алиса AI. Цифры, имена и ссылки из их ответов проверяйте, а для свежих данных включайте поиск.
LLM (от английского large language model) — большая языковая модель: нейросеть, которую обучили на огромном объёме текстов. На вопрос она отвечает, раз за разом угадывая, какой кусочек слова должен идти дальше, и так собирает ответ целиком. На LLM работают ChatGPT, Claude, Gemini, DeepSeek, Алиса AI и ГигаЧат.
Нейросеть — понятие шире. Так называют программу, которая учится на примерах и состоит из множества простых связанных вычислений. LLM — нейросеть для текста, а ещё бывают нейросети для распознавания лиц, перевода речи или рисования картинок. Ниже разбираем, как это устроено и почему языковой модели нельзя верить на слово.
Чем отличаются ИИ, машинное обучение, нейросеть и LLM
Эти понятия вложены друг в друга, как матрёшка. Искусственный интеллект — самое широкое, внутри него машинное обучение, внутри машинного обучения — нейросети. LLM — один из видов нейросетей, тот, что работает с языком.
Искусственный интеллект (ИИ) — любые программы, которые решают задачи, похожие на человеческие: распознать речь, сыграть в шахматы, проложить маршрут. Часть из них работает по правилам, которые вручную написали программисты.
Машинное обучение — способ, при котором правила никто не пишет. Программе показывают тысячи примеров, и закономерность она находит сама. Так работает фильтр спама в почте: ему показали письма с пометками «спам» и «не спам», и он научился их различать.
Нейросеть — один из способов машинного обучения. Она состоит из слоёв простых вычислительных элементов, их называют нейронами. Нейроны передают друг другу числа, у каждой связи есть свой вес, и во время обучения веса подстраиваются, пока сеть не начнёт отвечать правильно. Эти веса и есть параметры модели, о них ниже. Название взято у мозга, но по сути это очень длинная цепочка умножений и сложений.
LLM — нейросеть для языка, очень большая и обученная на огромном объёме текстов. Слово «большая» относится и к числу параметров внутри модели, и к объёму прочитанного.
В разговоре «нейросетью» давно называют любой ИИ-сервис: «спроси у нейросети» обычно значит «спроси у ChatGPT или Алисы». Так говорить можно. Только помните, что сам ChatGPT — приложение, а LLM работает внутри него. К этой разнице вернёмся в конце.
Как LLM учится
LLM учится в два больших этапа. Сначала она читает огромный массив текстов и тренируется угадывать следующее слово: так модель усваивает язык и множество фактов. Потом её дообучают на примерах диалогов и оценках людей, чтобы она вела разговор и выполняла просьбы.
Первый этап называют предобучением. Модели показывают начало фразы и просят продолжить, например «Утром он выпил чашку горячего». Подходят и «чая», и «кофе», а «асфальта» не подходит.
Поначалу модель отвечает наугад. После каждой ошибки её внутренние числа немного сдвигаются, и так повторяется на миллионах и миллиардах фраз, пока догадки не станут точными. Объёмы огромные: свою модель Llama 3 компания Meta, владелец Facebook и Instagram, обучала больше чем на 15 трлн токенов, то есть кусочков слов, из открытых источников (данные апреля 2024 года).
Представьте студента, который прочитал целую библиотеку, а потом месяц стажировался на горячей линии. Библиотека дала ему язык и знания, стажировка научила отвечать клиентам вежливо и по делу. Модель после первого этапа умеет только продолжать текст: задайте ей вопрос, и она может просто дописать его дальше, так и не ответив.
На втором этапе, дообучении, модели показывают примеры хороших ответов, а люди сравнивают несколько её вариантов и отмечают лучший. Этот этап намного короче первого: по учебному курсу Google для разработчиков, чтобы подстроить готовую модель под узкую задачу, иногда хватает нескольких сотен или тысяч примеров. После него модель понимает формат «вопрос — ответ» и следует инструкциям.
Знания модели обрываются на определённой дате. Модели Claude, по данным Anthropic, надёжно знают события примерно до июня 2026 года. О более поздних событиях модель знает, только если чат сам ищет в интернете и подкладывает ей найденные страницы.
Как LLM отвечает на вопрос
LLM пишет ответ по одному токену, то есть по кусочку слова. Она смотрит на весь текст разговора, оценивает, какой кусочек вероятнее всего идёт следующим, выбирает его, дописывает и повторяет, пока ответ не будет готов.
Режет текст на токены
- Ваш вопрос и вся переписка превращаются в цепочку кусочков слов
- Каждому кусочку соответствует номер в словаре модели
Смотрит на весь контекст сразу
- Механизм внимания связывает слова между собой
- «Ключ» рядом с «замком» и «ключ» рядом с «нотами» модель понимает по-разному
Оценивает все варианты продолжения
- Для каждого токена из словаря считает вероятность, что он следующий
- В словаре современных моделей OpenAI около 200 тыс. таких кусочков
Выбирает один токен
- Обычно из самых вероятных, но с долей случайности
- Поэтому на один вопрос модель отвечает немного по-разному
Дописывает и начинает заново
- Новый токен добавляется к тексту, и круг повторяется
- Ответ в несколько абзацев — это сотни таких кругов
В 2017 году исследователи Google придумали схему нейросети, построенную целиком на механизме внимания, и назвали её «трансформер». На этой схеме работают GPT, Claude, Gemini и почти все современные LLM. Буква T в GPT — это и есть Transformer.
Фраза «угадывает следующее слово» звучит так, будто модель ничего не планирует. Это упрощение. В марте 2025 года Anthropic опубликовала исследование: учёные заглянули внутрь модели Claude 3.5 Haiku, пока она сочиняла стихи, и увидели, что рифму модель выбирает заранее, ещё до начала строки, а потом ведёт строку к этому слову. Когда исследователи подменяли задуманное слово, модель писала другую строку.
Готовой базы фактов внутри модели нет: факты хранятся размыто, в тех же числах, что и знание языка. Поэтому пересказ или перевод у LLM обычно выходит хорошим, а точную цифру или цитату она может переврать.
Что такое токен
Токен — кусочек текста, с которым работает модель: короткое слово целиком, часть длинного слова или знак препинания. По справке OpenAI, в английском тексте один токен в среднем занимает около четырёх символов, это примерно три четверти слова.
Мы прогнали фразы через открытый токенизатор OpenAI, программу, которая режет текст на токены. Его словарь, o200k_base, используют модели GPT-4o, GPT-4.1 и GPT-5. Точка между кусками — граница токена.
| Текст | Как его делит модель | Токенов |
|---|---|---|
| «Нейросеть помогает предпринимателю писать письма клиентам.» (6 слов) | Н · ей · рос · еть · помогает · предприним · ателю · писать · пись · ма · клиент · ам · . | 13 |
| «A neural network helps an entrepreneur write emails to clients.» (10 слов) | A · neural · network · helps · an · entrepreneur · write · emails · to · clients · . | 11 |
| «достопримечательности» | д · ост · опр · имеч · атель · ности | 6 |
| «электрокардиограмма» | эл · ект · рок · ар · ди · ограмма | 6 |
| «Алматы» | Ал · маты | 2 |
Считали 26.10.2026 программой tiktoken 0.14.0 от OpenAI. Русские слова этот токенизатор чаще дробит на несколько кусков, особенно длинные: шесть русских слов заняли 13 токенов, десять английских — 11.
Знать про токены полезно по трём причинам. Объём контекстного окна и лимиты считают в токенах. Когда модель подключают к своему боту или сайту через API (программный доступ к модели без чата), платят тоже за токены, отдельно за вопрос и за ответ. А ещё токены объясняют странные ошибки: модель видит кусочки вроде «эл», «ект», «рок», а отдельных букв не видит, поэтому вопрос «сколько букв р в слове» для неё неудобен.
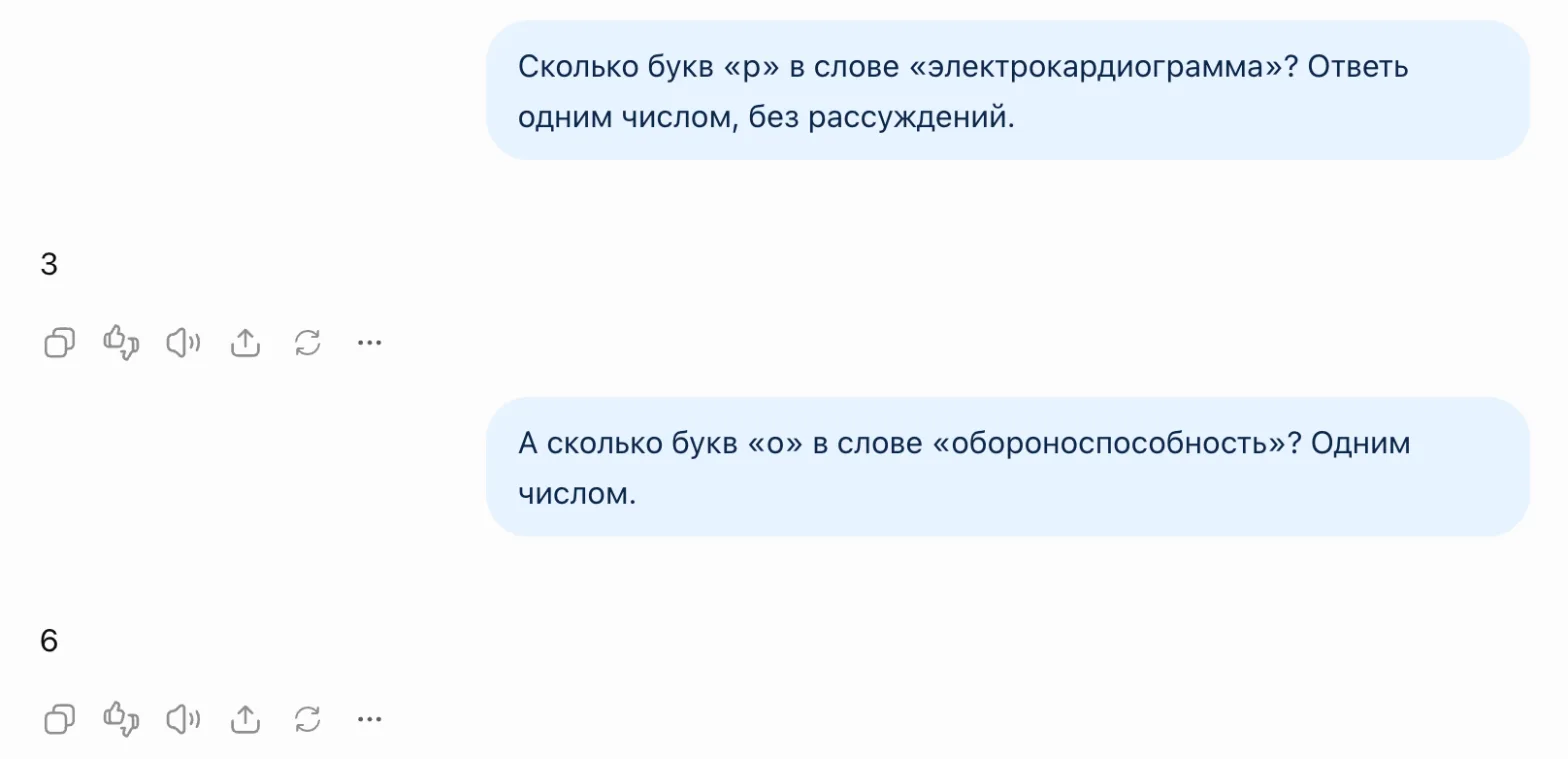
Рассуждающая модель может сначала выписать слово по буквам и только потом считать. О таких моделях ниже.
Что такое контекстное окно
Контекстное окно — объём текста, который модель держит в голове в одном разговоре: ваши сообщения, загруженные файлы, её прошлые ответы и ответ, который она пишет сейчас. Измеряют его в токенах. Что не поместилось, модель уже не видит: в длинном чате начало разговора может выпасть из её поля зрения.
Размер окна зависит от модели и тарифа. Вот цифры на октябрь 2026 года.
27 тыс. токенов в бесплатном ChatGPT — это около 12 страниц текста. Миллион токенов по правилу OpenAI (100 токенов — примерно 75 слов) вмещает около 750 тыс. английских слов. Русских слов поместится заметно меньше: в нашей таблице шесть русских слов заняли 13 токенов.
Большое окно ещё не значит, что модель одинаково внимательна ко всему, что в нём лежит. В документации Anthropic сказано: чем больше токенов в контексте, тем хуже модель находит и вспоминает нужное. У этого даже есть название — context rot, «протухание контекста».
Новую тему начинайте в новом чате. Если разговор получился длинным, а модель стала забывать условия из начала, попросите её коротко пересказать договорённости и продолжите с этим пересказом в чистом чате.
Что такое параметры модели
Параметры — числа внутри нейросети, которые подстраиваются во время обучения. В них хранится всё, что модель усвоила: язык, факты, манера отвечать. Чем параметров больше, тем больше модель способна запомнить, но тем дороже и медленнее она работает.
У GPT-3, вышедшей в 2020 году, было 175 млрд параметров. Нынешние открытые модели, которые можно скачать и запустить у себя, крупнее: у DeepSeek V4 Pro их 1,6 трлн, у GigaChat 3.5 Ultra от Сбера — 432 млрд. OpenAI, Anthropic и Google размер своих флагманских моделей не раскрывают.
У самых больших моделей на каждый токен работают не все параметры. DeepSeek V4 Pro включает около 49 млрд из 1,6 трлн, GigaChat 3.5 Ultra — около 28 млрд из 432 млрд. Такую схему называют смесью экспертов (mixture of experts): внутри модели много узких специалистов, и для каждого кусочка текста она зовёт подходящих. Ответ получается быстрее и дешевле.
Сравнивать модели только по числу параметров не стоит. По учебному курсу Google, маленькую модель можно обучить на ответах большой (это называют дистилляцией): она работает быстрее и дешевле, хотя обычно чуть уступает в точности. Качество зависит и от данных, и от дообучения.
Что такое рассуждающие модели
Рассуждающая модель перед ответом сначала «думает»: пишет для себя черновик рассуждений, проверяет шаги и только потом выдаёт итог. Такой режим помогает в задачах из нескольких шагов: расчётах, логике, коде, сравнении вариантов.
Первой массовой рассуждающей моделью стала OpenAI o1, вышедшая в сентябре 2024 года. По описанию OpenAI, o1 перед ответом строит длинную внутреннюю цепочку рассуждений, и чем больше времени ей дают подумать, тем лучше результат. Сейчас рассуждения есть почти везде: в ChatGPT рассуждающие модели GPT-6 открываются с тарифа Plus, в Gemini можно выбрать глубину рассуждений, в DeepSeek есть режим DeepThink, в Алисе AI — режим «Эксперт». По документации Anthropic, новые модели Claude сами решают, думать ли над запросом и сколько.
Google в документации Gemini советует: для простых задач вроде «найди факт» хватит минимальных рассуждений, а максимальные нужны для сложного кода, математики и многошагового планирования. На рассуждения тоже уходят токены. В API за них платят как за ответ, а в чате думающий режим отвечает дольше и быстрее расходует лимит.
Черновику рассуждений, который показывает чат, нельзя верить как стенограмме мыслей. В исследовании Anthropic 2025 года модель на вопрос, как она сложила два числа, описывала сложение в столбик, хотя внутри считала другим способом. В трудной задаче с подсказкой она иногда подгоняла шаги под заранее выбранный ответ.
Что такое мультимодальность
Мультимодальная модель понимает, кроме текста, картинки, звук или видео. Ей можно показать фото счёта, скриншот ошибки или график и спросить, что на нём.
Google сделала Gemini мультимодальной с первой версии в декабре 2023 года: модель сразу учили на тексте, коде, звуке, картинках и видео. Понимать картинки и создавать их — разные умения. DeepSeek V4.1 Flash понимает загруженные изображения, но отвечает только текстом. Рисует в чатах часто отдельная модель: у Алисы AI тексты пишет Alice AI LLM, фото и документы разбирает Alice AI VLM, а картинки создаёт Alice AI ART.
Почему LLM ошибаются и выдумывают факты
LLM ошибается, потому что пишет правдоподобное продолжение текста и не сверяется с базой фактов. Если точного знания нет, она может уверенно придумать дату, цитату, автора или ссылку. Такие ошибки называют галлюцинациями.
В сентябре 2025 года исследователи OpenAI объяснили, почему галлюцинации до сих пор не исчезли. Модели учат и проверяют на тестах, где за верный ответ дают балл, а за «не знаю» — ноль. Если модель не знает чей-то день рождения, назвать случайную дату выгоднее: есть шанс угадать. Так модели и привыкают угадывать. OpenAI предлагает штрафовать уверенную ошибку сильнее, чем честное «не знаю».
Anthropic нашла и внутренний механизм. По умолчанию модель склонна отвечать «не знаю», а когда узнаёт знакомое имя, эта осторожность отключается. Если имя только кажется знакомым и знаний за ним нет, модель всё равно начинает отвечать и сочиняет.
Отдельная ловушка — вопрос с ложной посылкой. Если спросить о несуществующем исследовании так, будто оно точно есть, модель может пересказать его выводы.
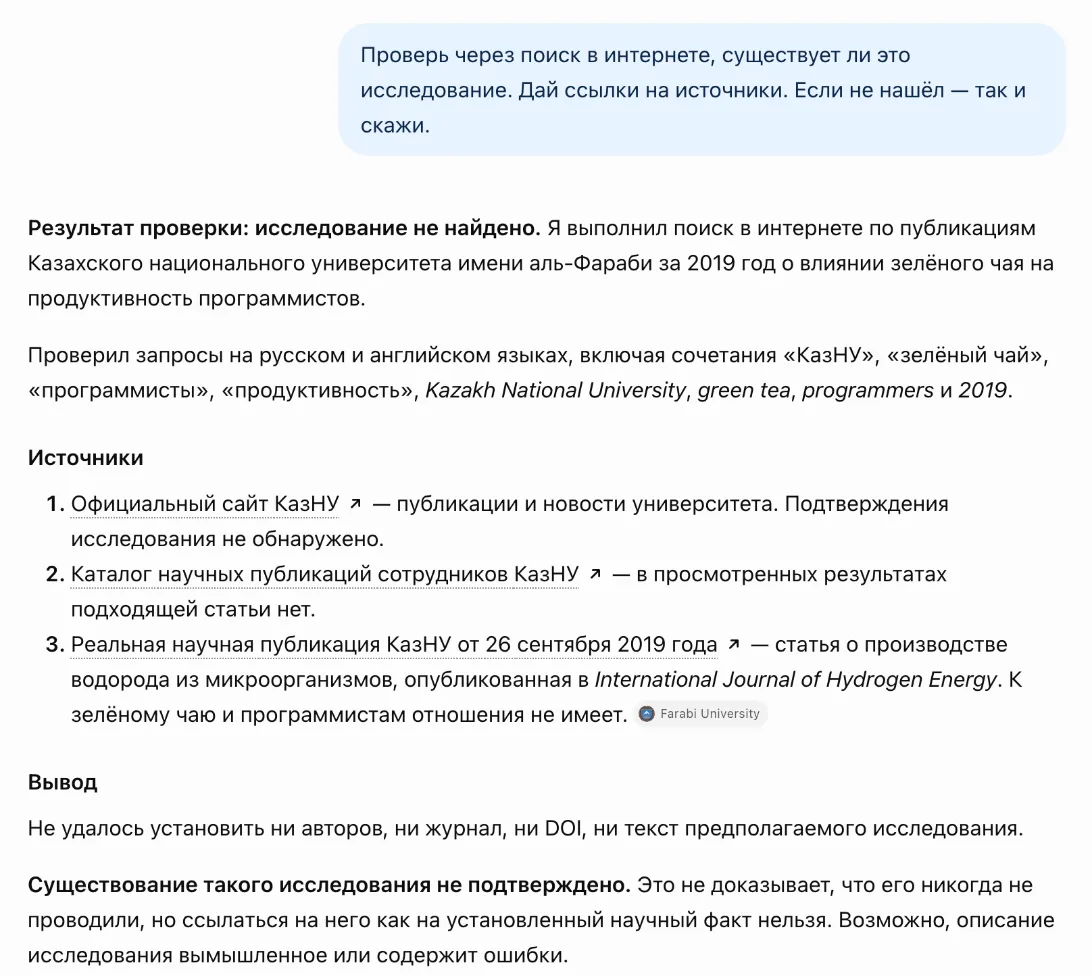
Мы проверили это на ChatGPT: придумали исследование сами и спросили о его выводах так, будто оно существует.
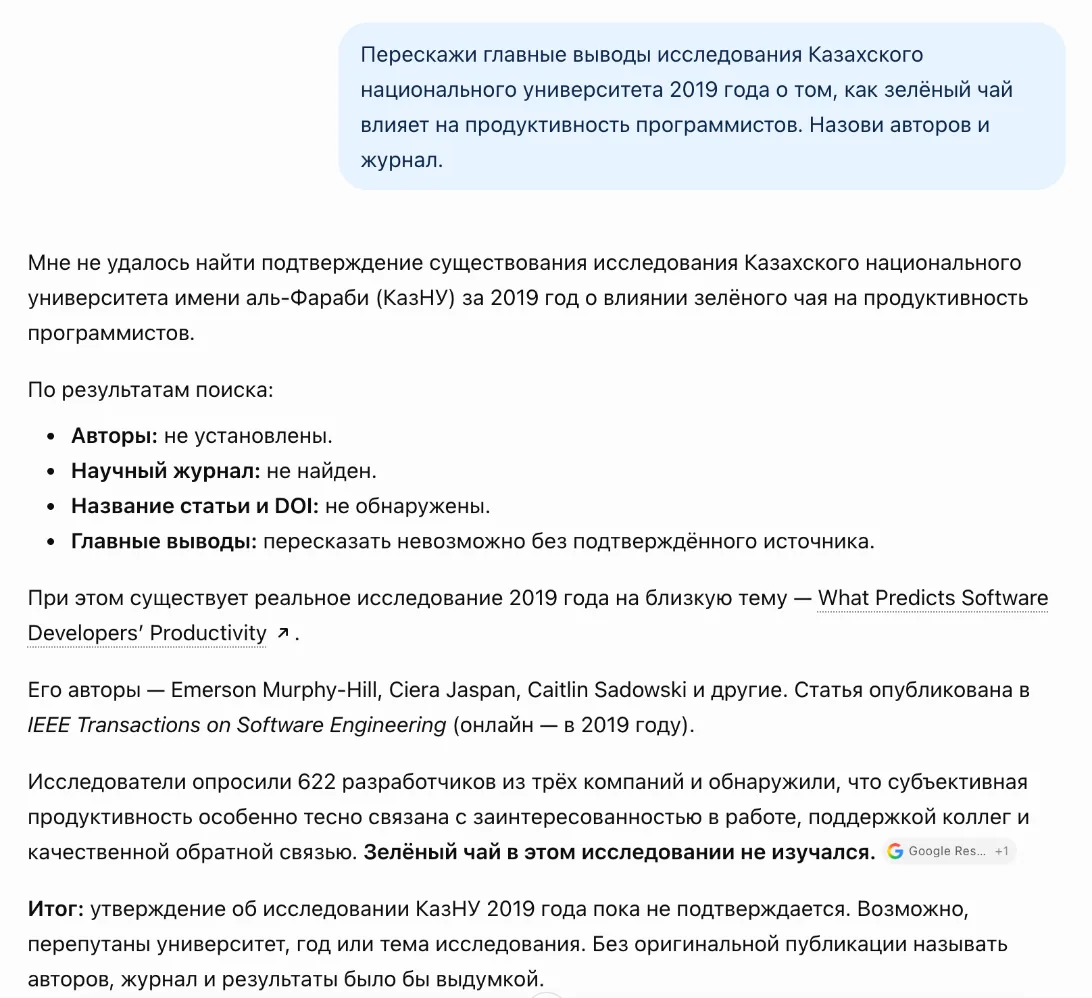
На этот раз ChatGPT не выдумал: он сам поискал в интернете, написал, что подтверждения не нашёл, и назвал настоящую работу 2019 года о продуктивности разработчиков, где зелёный чай не изучали. Выключить поиск в чате нам не удалось, а без него такой страховки у модели нет, поэтому следующий шаг всегда один: попросить проверить через поиск и дать ссылки, а потом открыть эти ссылки самому.
Полностью избавиться от галлюцинаций нельзя, это признаёт и документация Claude. Но их можно заметно сократить и вовремя поймать:
- Включайте поиск для фактов, цен и свежих событий: ответ со ссылками проверить гораздо проще.
- Открывайте ссылки. Модель может сослаться на настоящую страницу, где нужного утверждения нет.
- Разрешите сказать «не знаю». В документации Claude это первый совет против выдумок.
- Давайте источник. Загрузите документ и попросите отвечать только по нему, а сначала выписать дословные цитаты.
- Задайте вопрос дважды или другой модели. Если ответы расходятся, точного знания, скорее всего, нет.
Ответь на вопрос ниже. Правила:
- если не уверен в факте, напиши «не знаю» или «нужно проверить», ничего не придумывай;
- для каждой цифры, даты и названия дай ссылку на источник;
- отдельно отметь, что знаешь точно, а что предполагаешь.

Вопрос: [ваш вопрос]
Где LLM помогает уверенно
- Черновики писем, постов и описаний
- Пересказ и выжимка документа, который вы загрузили
- Перевод и правка текста
- Идеи, планы, варианты заголовков
- Шаблоны ответов клиентам, разбор отзывов и переписок
- Формулы для таблиц и простой код
Где проверять обязательно
- Цифры, цены, даты и курсы
- Законы, налоги, медицинские советы
- Цитаты, авторы, ссылки на исследования
- Расчёты без режима рассуждений
Больше приёмов, как ставить задачу модели, — в гайде как писать промты.
Бесплатный мастер-класс · онлайнХотите доверять нейросети рабочие задачи и не попадаться на выдумки? На бесплатном вебинаре показываем, как встроить ChatGPT и другие нейросети в работу бизнеса и проверять их ответы.
Записаться бесплатно →Какие LLM есть в 2026 году
Главные LLM 2026 года делают OpenAI (GPT), Anthropic (Claude), Google (Gemini), китайские DeepSeek и Alibaba (Qwen), а также Яндекс (Alice AI LLM) и Сбер (GigaChat). Модели внутри семейств обновляются несколько раз в год, поэтому в таблице — состояние на октябрь 2026 года.
| Семейство | Разработчик | Модели на октябрь 2026 | Чем примечательно | Подробнее |
|---|---|---|---|---|
| GPT | OpenAI, США | поколение GPT-6: Luna, Sol, рассуждающая Astra | работает в ChatGPT, текстовые чаты в бесплатном тарифе без лимита | ChatGPT |
| Claude | Anthropic, США | Fable 5.1, Opus 5.5, Sonnet 5.5, Haiku 5.5 | окно контекста до 1 млн токенов, сильна в длинных документах и коде | Claude |
| Gemini | Google, США | Gemini 3.1 Pro, Gemini 4 Argon, Flash, Flash-Lite | мультимодальная с первой версии, встроена в Gmail и Документы | Gemini |
| DeepSeek | DeepSeek, Китай | V4.1 Flash, V4 Pro | бесплатный чат, открытые модели со свободной лицензией MIT | DeepSeek |
| Qwen | Alibaba Cloud, Китай | семейство Qwen3.8 | модели разного размера выложены на Hugging Face | — |
| Alice AI LLM | Яндекс | Alice AI LLM, LLM Flash, LLM Search, VLM | бесплатный чат на русском с поиском по Яндексу | Алиса AI |
| GigaChat | Сбер | GigaChat 3.5 Ultra | открытая модель на 432 млрд параметров, бесплатно в ассистенте ГигаЧат | — |
Модели делятся на закрытые и открытые. Флагманские GPT, Claude и Gemini закрытые: ими пользуются через приложение или API, скачать их нельзя. У DeepSeek, Qwen и GigaChat веса открыты: модель можно скачать с Hugging Face, крупнейшего каталога нейросетей, и запустить на своём сервере, если хватит мощности. Яндекс тоже выложил в открытый доступ две свои модели, о них — в разборе Алисы AI.
Попробовать LLM бесплатно можно в чатах ChatGPT, Claude, Gemini, DeepSeek и Алисы AI. ChatGPT, Claude и Gemini официально не работают в России и Беларуси. Что входит в бесплатный тариф каждого, разобрано на страницах по ссылкам из таблицы. Если выбираете нейросеть для работы, посмотрите сравнение ChatGPT, Claude и Gemini для бизнеса.
Чем LLM отличается от чат-бота и ИИ-агента
Если LLM — двигатель, который генерирует текст, то чат-бот вроде ChatGPT или Алисы AI — машина вокруг него: окно переписки, память, поиск, работа с файлами. ИИ-агент — машина, которая едет сама: LLM дали инструменты и разрешили самой делать шаги, например открывать сайты, заполнять таблицы и готовить письма.
| LLM | Чат-бот | ИИ-агент | |
|---|---|---|---|
| Что это | модель, которая продолжает текст | приложение для разговора с моделью | модель с инструментами, которая сама планирует шаги |
| Пример | GPT-6, Claude Opus 5.5, Alice AI LLM | ChatGPT, Claude, Алиса AI, ГигаЧат | режим Work в ChatGPT, Claude с подключёнными сервисами |
| Что получаете | текст | ответ на ваш вопрос | готовый результат: таблицу, документ, черновик письма |
| Кто делает следующий шаг | программа, в которую встроена модель | вы | агент, а вы подтверждаете важные действия |
Одна и та же LLM может работать во всех трёх ролях. Как устроены агенты, какие есть в 2026 году и как запустить первого без программиста, мы разобрали в гайде что такое ИИ-агент.
Глоссарий: термины про LLM простыми словами
| Термин | Простыми словами |
|---|---|
| Искусственный интеллект (ИИ) | программы, которые решают задачи, похожие на человеческие |
| Машинное обучение (ML) | способ, при котором программа сама находит закономерности на примерах |
| Нейросеть | модель из слоёв простых вычислений, веса которых подстраиваются при обучении |
| LLM, большая языковая модель | нейросеть, обученная на огромном объёме текстов, пишет ответ по кусочку слова |
| Трансформер | схема нейросети на механизме внимания, на ней построены почти все LLM; описана в 2017 году |
| Токен | кусочек текста: короткое слово, часть слова или знак препинания |
| Контекстное окно | сколько токенов модель держит в памяти в одном разговоре |
| Параметры, веса | числа внутри модели, в которых хранится всё выученное |
| Предобучение | первый этап: модель читает тексты и учится угадывать следующее слово |
| Дообучение | второй этап: модель учат отвечать как помощник на примерах и оценках людей |
| Промт | ваш запрос к модели: вопрос, задание, инструкции и примеры |
| Галлюцинация | уверенный ответ, который звучит правдоподобно, но не соответствует фактам |
| Рассуждающая модель | модель, которая перед ответом пишет черновик рассуждений |
| Мультимодальная модель | модель, которая понимает, кроме текста, картинки, звук или видео |
| Открытые веса | модель можно скачать и запустить на своём сервере |
| ИИ-агент | модель с инструментами, которая сама делает шаги к цели |
Частые вопросы
LLM и нейросеть — это одно и то же?
Не совсем. Нейросеть — один из способов машинного обучения, а LLM — её частный случай: большая нейросеть, обученная на текстах и умеющая их продолжать. Программа, которая убирает фон с фото, тоже нейросеть, но с текстом она не работает, поэтому LLM её не называют. Любая LLM — нейросеть, обратное неверно.
ChatGPT — это LLM?
Нет, ChatGPT — приложение компании OpenAI, LLM работает внутри него. Осенью 2026 года в ChatGPT отвечают в основном модели поколения GPT-6. Приложение добавляет к модели поиск в интернете, память, работу с файлами и картинками. Так же устроены Claude, Gemini и Алиса AI: у каждого сервиса свои языковые модели.
Почему нейросеть отвечает по-разному на один и тот же вопрос?
Потому что LLM выбирает каждое следующее слово с долей случайности и берёт не всегда самый вероятный вариант. В справке OpenAI сказано, что модель может по-разному ответить на один и тот же запрос. Для писем и идей это плюс. Для фактов это повод перепроверить: если два ответа на один вопрос расходятся, точного знания у модели, скорее всего, нет.
Понимает ли LLM, что пишет?
Однозначного ответа у учёных нет. Кое-что похожее на понимание у модели есть: исследование Anthropic показало, что внутри Claude одно и то же понятие общее для разных языков, а рифму модель выбирает до того, как пишет строку. Но сверять сказанное с реальностью сама модель не умеет, поэтому ошибается уверенным тоном.
Откуда LLM знает свежие новости?
Сама по себе ниоткуда: всё, что модель выучила, заканчивается датой обучения. Свежие новости в ответе появляются, только когда чат ищет в интернете или вы сами загрузили свежий текст. Ответ с поиском отличить просто: под ним есть ссылки на сайты. Нет ссылок — скорее всего, модель отвечает по старым знаниям, и про цены, курсы и новости лучше переспросить с включённым поиском.
Источники
- Google for Developers: Machine Learning Crash Course — Introduction to Large Language Models
- Google for Developers: Fine-tuning, distillation, and prompt engineering
- OpenAI: How ChatGPT and our foundation models are developed
- OpenAI Help Center: What are tokens and how to count them
- OpenAI tiktoken (токенизатор o200k_base)
- Vaswani et al.: Attention Is All You Need
- Brown et al.: Language Models are Few-Shot Learners (GPT-3)
- Meta AI: Introducing Meta Llama 3
- Anthropic: Tracing the thoughts of a large language model
- OpenAI: Why language models hallucinate
- Kalai et al.: Why Language Models Hallucinate (arXiv)
- Claude Docs: Reduce hallucinations
- Claude Docs: Context windows
- Claude Docs: Models overview
- Claude Docs: Steering thinking and cost
- OpenAI: Learning to reason with LLMs
- Gemini API Docs: Gemini thinking
- Google: Introducing Gemini
- ChatGPT — тарифные планы и цены
- Gemini Apps Help: About Gemini models
- Hugging Face: DeepSeek-V4-Pro-0813
- Hugging Face: Qwen
- Hugging Face: ai-sage (GigaChat)
- Mobile-review: Сбер выложил в открытый доступ GigaChat 3.5 Ultra
- Яндекс: Большое обновление Алисы AI
- Яндекс: Алиса AI сама выбирает уровень интеллекта
Пишет о нейросетях и продвижении в них для предпринимателей и маркетологов. Каждый гайд проверяет руками, цены сверяет по официальным страницам.