Локальная нейросеть — открытая модель, которая работает на вашем компьютере: запросы и документы не уходят в облако, подписка не нужна, после скачивания интернет не требуется. Проще всего поставить её через LM Studio (окно чата, без команд) или Ollama (запускается одной командой, её легко подключить к своим программам и ботам). Обе бесплатны, в том числе для работы в компании. Модель выбирают по памяти: на ноябрь 2026 года актуальны Gemma 4 от Google, Qwen версий 3.5-3.8 от Alibaba и gpt-oss от OpenAI, а Llama 3 и Mistral 7B, которые до сих пор советуют многие инструкции, устарели.
Локальная нейросеть — это открытая модель, которую скачивают на свой компьютер и запускают в бесплатной программе Ollama или LM Studio. После скачивания она отвечает без интернета и подписки, а переписка и файлы остаются у вас. Какую модель брать, решает память: 8 ГБ хватит на Gemma 4 E2B, 16 ГБ — на Gemma 4 E4B или Qwen3.5 9B, 32 ГБ — на модели уровня Gemma 4 31B.
Ниже — как выбрать программу и модель под ваш компьютер и задачи. Пошаговая установка моделей одного семейства со всеми настройками разобрана в гайде Qwen локально на компьютере.
Что такое локальная нейросеть и зачем она бизнесу?
Локальная нейросеть — языковая модель, файл которой лежит на вашем диске, а расчёты идут на вашем процессоре и видеокарте. ChatGPT, Claude и Gemini работают иначе: текст запроса уходит на сервер компании, ответ приходит обратно. Внутри локальная модель устроена так же, как облачная, только меньше. Как работают такие модели, мы объясняли в статье что такое LLM.
Бизнесу своя модель полезна в трёх случаях.
Документы нельзя отдавать в чужое облако. Договоры, базы клиентов, медицинские и финансовые данные. По документации Ollama, при локальной работе разработчики программы не видят ваши запросы и данные. У LM Studio набранное в чате и загруженные для разбора файлы тоже не покидают компьютер.
Подписка на каждого сотрудника обходится дорого. ChatGPT Plus стоит $20 (≈1 640 ₽) в месяц на человека. Для десяти сотрудников это $2 400 (≈197 130 ₽) в год по курсу ЦБ на 07.11.2026. Локальную модель можно поставить на один мощный компьютер для всех сотрудников: сама модель бесплатна, расходы — железо и электричество. Если моделью пользуются сразу несколько человек, ответы идут по очереди, так что для офиса берут компьютер помощнее.
Работа не должна зависеть от зарубежного сервиса. Облачный чат может закрыть доступ в стране, заблокировать аккаунт или поменять тарифы. Скачанная модель остаётся на диске в той версии, которую вы проверили, и её не обновят и не отключат без вашего ведома.
стоят Ollama, LM Studio и открытые модели со свободной лицензией
памяти хватает на средние модели Gemma 4 и Qwen3.5, а gpt-oss 20b от OpenAI идёт впритык
в год стоит ChatGPT Plus на десять сотрудников, ≈197 130 ₽
Ollama или LM Studio: что выбрать?
Если вы не работаете с командной строкой, ставьте LM Studio: в ней есть каталог моделей с поиском и привычное окно чата. Ollama удобнее, когда модель нужно подключить к своим программам, ботам или CRM: она запускает модель одной командой и сразу открывает API, то есть вход, через который к модели обращаются другие программы. Обе бесплатны.
| LM Studio | Ollama | |
|---|---|---|
| Как выглядит | окно чата, вкладка поиска моделей | команда в терминале, есть простое приложение-чат для Mac и Windows |
| Как скачать модель | найти в каталоге и нажать Download | ollama run имя-модели |
| Чат с документами | есть, работает без интернета | в приложении можно перетащить PDF или текст |
| Подключение к своим программам | локальный сервер на компьютере или в сети офиса | API на localhost:11434, совместим с API OpenAI |
| Условия использования | бесплатно, в том числе для работы, с июля 2025 года | бесплатно, открытый код, лицензия MIT |
| Облачные модели в каталоге | помечены Cloud | с окончанием :cloud |
| Mac на Intel | не поддерживается | работает, но только на процессоре |
Обе программы ставят на Windows, Mac и Linux. LM Studio на Windows нужен процессор с набором команд AVX2, на Mac — чип M1 и новее с macOS 14. Подробные требования к системе собраны в таблице гайда по Qwen.
Модели у обеих программ одни и те же, поэтому выбор программы почти не влияет на качество ответов. Многие ставят обе: LM Studio для разговоров и поиска моделей, Ollama для автоматизации.
Простое правило для типичных ситуаций. Для личного помощника с письмами и документами на своём ноутбуке берите LM Studio. Для бота на сайте, обработки заявок скриптом или помощи программисту в редакторе кода берите Ollama. Если модель нужна нескольким сотрудникам, подойдут обе, но Ollama проще оставить в фоне на отдельном компьютере. Она сама загружает модель в память по запросу и выгружает через 5 минут простоя.
В обзорах ещё советуют Jan и GPT4All. Jan — бесплатная программа с открытым кодом и окном чата, похожая на LM Studio. GPT4All последний раз обновлялся в феврале 2025 года, свежие модели в нём могут не запуститься, так что начинать с него в 2026 году мы бы не стали.
Какой компьютер нужен для локальной нейросети?
Нужна память: модель должна целиком поместиться в оперативную память или в память видеокарты, с запасом под систему и переписку. По нашей оценке, удобно, когда свободной памяти на 30-50% больше, чем весит файл модели. Модели впритык тоже запускаются, но оставляют мало места под переписку и другие программы. Мощность процессора и видеокарты влияет на скорость, а запустится ли модель, решает объём памяти.
Размер модели меряют в параметрах: это числа, которые модель выучила при обучении. Чем их больше, тем модель умнее и тем тяжелее её файл.
| Память компьютера | Что потянет | Примеры моделей |
|---|---|---|
| 8 ГБ | маленькие модели для черновиков и пересказов | Gemma 4 E2B (4,6 ГБ), Qwen3.5 4B (3,3-4 ГБ), Ministral 3 3B |
| 16 ГБ | средние модели, большинство офисных задач | Gemma 4 E4B (6,6-9,5 ГБ) и 12B (7,7-8 ГБ), Qwen3.5 9B (6,6-7,6 ГБ), gpt-oss 20b (14 ГБ, впритык) |
| 24 ГБ видеопамяти или 32 ГБ на Mac | сильные модели для кода и сложных документов | Gemma 4 26B (16-19 ГБ) и Qwen3.8 27B (18 ГБ), на 24 ГБ видеопамяти с небольшим запасом; Gemma 4 31B (19-20 ГБ) и Qwen3.6 35B (23 ГБ) впритык |
| 48 ГБ и больше | модели около 30 млрд параметров в менее сжатых версиях | Muse Glimmer от Meta (файл 25,77 ГБ, от 26 ГБ памяти), Gemma 4 31B в версии q8 (34 ГБ) |
Размеры файлов — из каталогов Ollama и LM Studio на ноябрь 2026 года. Это сжатые версии моделей: сжатие (его называют квантованием) уменьшает файл в несколько раз ценой небольшой потери точности.
На Mac с чипами M1 и новее память общая у процессора и графики, поэтому MacBook на 32 ГБ тянет модели, которым на Windows нужна видеокарта на 24 ГБ. На Windows считайте память видеокарты: Ollama поддерживает NVIDIA от старой GTX 750 Ti до RTX 5090, а без видеокарты модель работает на процессоре, только медленнее.
Какую модель выбрать в 2026 году?
На ноябрь 2026 года для компьютера актуальны пять семейств открытых моделей: Gemma 4 от Google, Qwen версий 3.5-3.8 от Alibaba, gpt-oss от OpenAI, Ministral 3 от Mistral и Muse Glimmer от Meta. Начинать лучше с Gemma 4 или Qwen: у них больше всего размеров под любую память, обе понимают картинки и много языков.
| Модель | Разработчик | Размеры для ПК | Лицензия | Чем хороша |
|---|---|---|---|---|
| Gemma 4 | E2B, E4B, 12B, 26B, 31B | Apache 2.0 | обучена на 140+ языках; маленькие E2B и E4B сделаны для ноутбуков и телефонов; понимают картинки, младшие — ещё и звук | |
| Qwen3.5, Qwen3.6, Qwen3.8 | Alibaba | от 0.8B до 35B | Apache 2.0 | самый широкий выбор размеров; Qwen3.6 сильнее в программировании, Qwen3.8 27B — самая свежая |
| gpt-oss | OpenAI | 20b (14 ГБ) | Apache 2.0 | работает при 16 ГБ памяти, уровень рассуждений настраивается: низкий, средний, высокий; только текст |
| Ministral 3 | Mistral AI | 3B, 8B, 14B | Apache 2.0 | компактные модели для слабого железа; русского нет в списке языков, которые Mistral называет в карточке, так что проверьте на своих задачах |
| Muse Glimmer | Meta | 30B | Apache 2.0 | 100+ языков, картинки, работа с инструментами; нужен компьютер от 26 ГБ памяти |
Все пять семейств выложены под Apache 2.0. Это свободная лицензия: модель можно бесплатно использовать в работе и встраивать в коммерческие продукты без отдельного соглашения с разработчиком.
Как Qwen справляется с русским языком по тестам Alibaba и какой его размер взять под ваш компьютер, разобрано в гайде по Qwen.
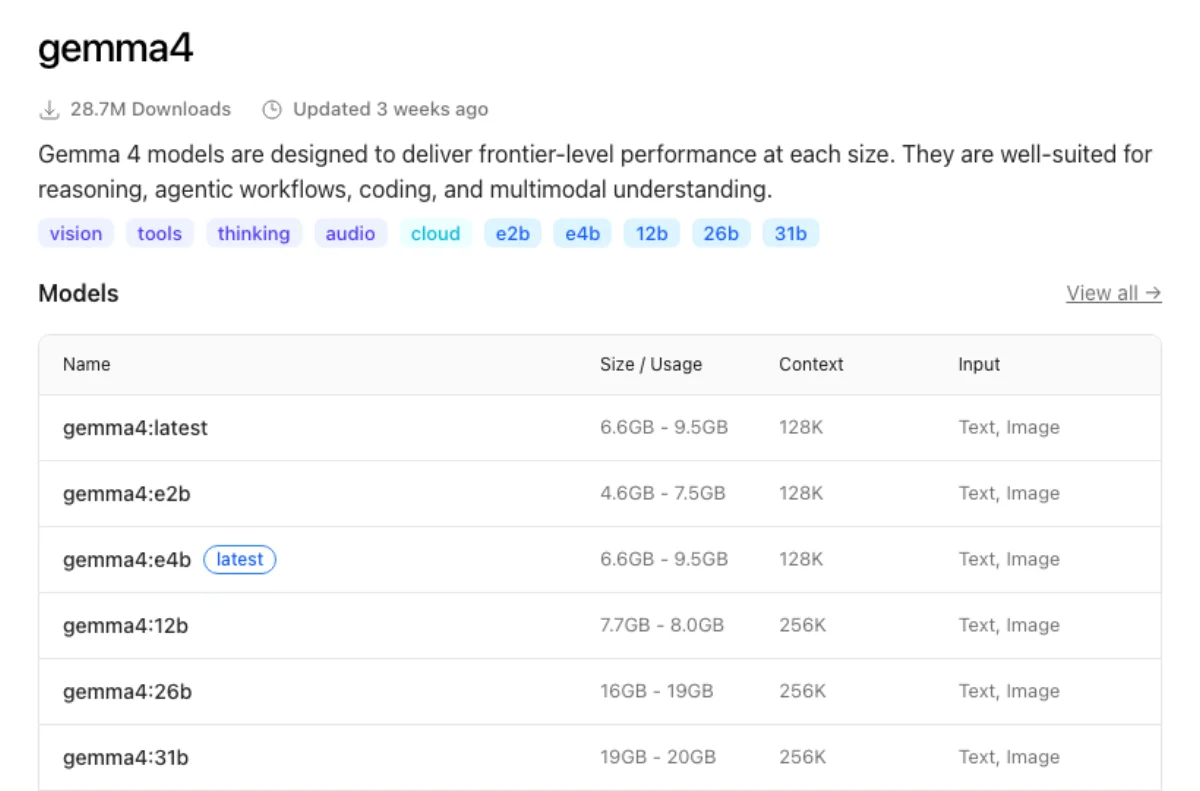
В названиях моделей зашифрован их размер. Буква B означает миллиарды параметров: Qwen3.5 9B — 9 млрд. У Gemma 4 E2B и E4B буква E значит «эффективные» параметры: по скорости модель работает как модель на 2,3 и 4,5 млрд, хотя файл у неё больше.
В названии Gemma 4 26B A4B вторая часть говорит об активных параметрах: из 25,2 млрд на каждое слово работают только 3,8 млрд, поэтому модель отвечает быстрее, чем обычная модель того же веса. Пометки q4 и q8 в списке файлов — степень сжатия: q4 легче, q8 тяжелее и чуть точнее.
Многие инструкции и чат-боты до сих пор советуют модели 2024-2025 годов. Они запустятся, но свежие модели того же размера отвечают лучше.
Устаревшие советы
- Llama 3.1 8B от Meta — обновлена год назад, Llama 3.2 того же поколения
- Mistral 7B — версия 0.3, обновлена год назад
- Qwen2.5 и Qwen3 — модели 2024-2025 годов
- Gemma 2 и Gemma 3 — заменены Gemma 4
Что ставить в ноябре 2026
- Gemma 4 E4B, 12B или 31B
- Qwen3.5 9B, Qwen3.8 27B
- gpt-oss 20b для рассуждений на 16 ГБ
- Gemma 4 E2B или Qwen3.5 4B для слабых ноутбуков
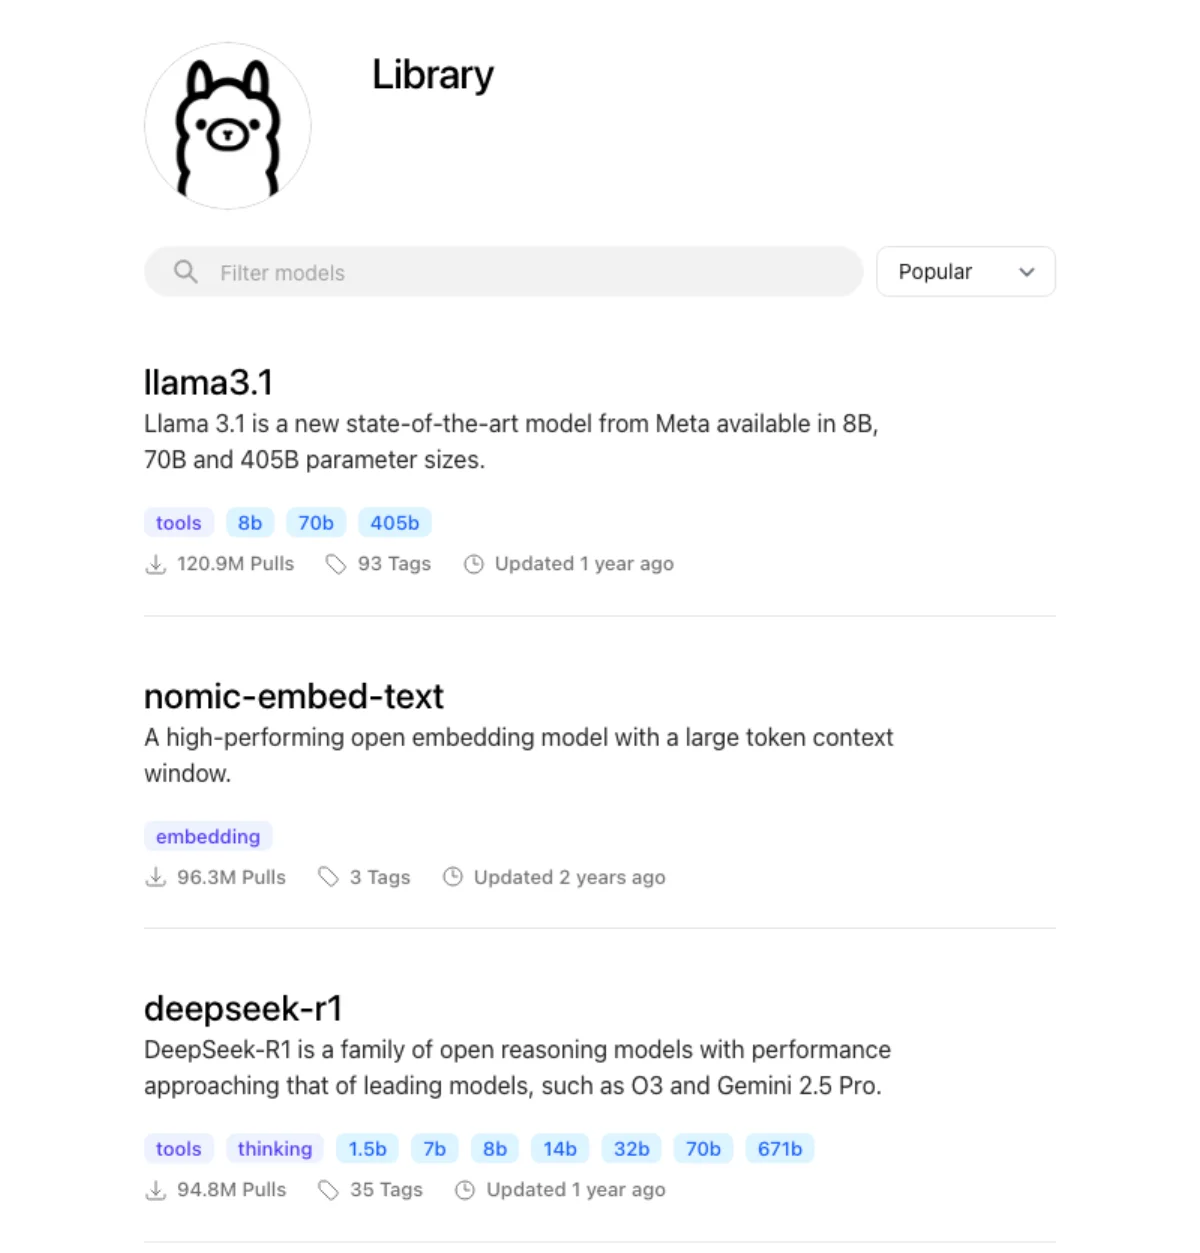
Llama у Meta для обычного компьютера тоже устарела. Llama 4 в каталоге Ollama есть только в огромных версиях 16x17b и 128x17b: они рассчитаны на сервер и на обычный компьютер не помещаются. Для своего компьютера у Meta теперь Muse Glimmer на 30 млрд параметров, ей нужно от 26 ГБ памяти.
Модели deepseek-r1:7b и deepseek-r1:14b в Ollama — небольшие модели Qwen, которых DeepSeek доучил рассуждать по образцу своей R1, а вариант на 70b сделан на основе Llama 3.3. С моделью из чата DeepSeek у них общее только имя: полная DeepSeek R1 весит 404 ГБ, а новые DeepSeek V4 Pro и V4.1 Flash в Ollama доступны только как облачные. Что умеет настоящий DeepSeek, мы собрали в обзоре DeepSeek.
Как запустить первую модель за 15 минут?
Быстрее всего поставить LM Studio и скачать модель из её каталога или ввести одну команду в Ollama. Дольше всего идёт загрузка файла на 5-10 ГБ, обычно это минуты.
В LM Studio: скачайте программу с lmstudio.ai, откройте поиск моделей, введите «Gemma 4» или «Qwen3.5», выберите размер под свою память и нажмите Download. Когда файл скачается, перейдите в чат и выберите модель вверху окна.
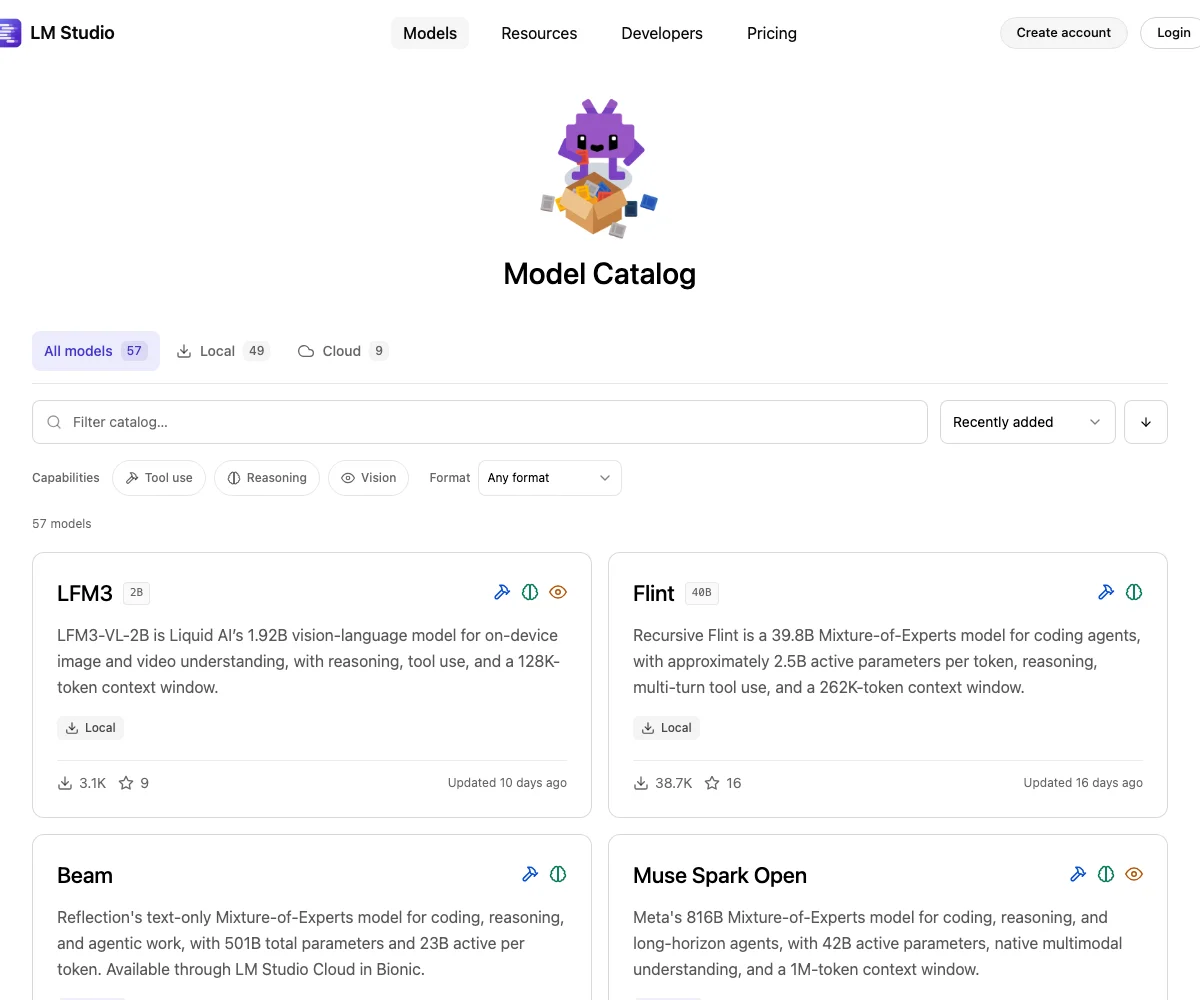
В Ollama: установите программу с ollama.com, откройте Терминал на Mac или командную строку в Windows и введите одну команду. Первый запуск скачивает модель, следующие открывают её сразу.
| Память | Команда | Что скачается |
|---|---|---|
| 8 ГБ | ollama run gemma4:e2b | Gemma 4 E2B, 4,6 ГБ |
| 16 ГБ | ollama run gemma4:e4b | Gemma 4 E4B, 6,6-9,5 ГБ |
| 16 ГБ, нужны рассуждения | ollama run gpt-oss:20b | gpt-oss 20b, 14 ГБ: впритык, закройте другие программы |
| 32 ГБ на Mac или 24 ГБ видеопамяти (впритык) | ollama run gemma4:31b | Gemma 4 31B, 19-20 ГБ |
Если ответы идут медленно или компьютер начинает тормозить, возьмите размер поменьше. Как проверить, поместилась ли модель в видеокарту, и что делать, если она «забывает» начало длинного документа, разобрано в гайде по Qwen: эти настройки одинаковы для всех моделей в Ollama.
Как проверить модель на своих задачах?
Скачайте две модели под свою память и дайте им одинаковые задачи из вашей работы. Цифры из тестов разработчиков не скажут, как модель напишет письмо вашему клиенту или разберёт ваш прайс. Хватит пяти заданий:
Отвечай по-русски, коротко и по делу.

1. Перескажи этот документ в пяти пунктах, отдельно выпиши все даты и суммы: [вставьте текст]
2. Клиент пишет: «Заказ опоздал на три дня, верните деньги». Напиши вежливый ответ: деньги вернём за доставку, не за товар.
3. Разложи эти отзывы на три группы: качество, доставка, цена. По каждой группе дай один вывод: [вставьте 10-20 отзывов]
4. Составь таблицу из этого текста: товар, цена, количество: [вставьте кусок прайса или переписки]
5. Посмотри на фото и опиши товар для карточки магазина в 300 знаках. [приложите фото]
Сравните ответы по трём признакам: нет ли ошибок в падежах, сходятся ли даты и суммы с документом, не придумала ли модель лишнего. Пятое задание проверяет работу с картинками, его дают только моделям с «зрением»: Gemma 4 и Qwen версий 3.5-3.8. Ещё больше задач, которые бизнесу стоит отдать нейросети, собрано в подборке 10 задач малого бизнеса.
Бесплатный мастер-класс · онлайнХотите понять, какие задачи вашего бизнеса уже можно отдать нейросети? На бесплатном мастер-классе «Как за 1 вечер освоить 20 нейросетей для работы, бизнеса и заработка» Даниил Сидоренко показывает, с чего начать.
Записаться бесплатно →Как подключить локальную нейросеть к рабочим программам?
Ollama и LM Studio работают как сервер, то есть как программа, которая ждёт запросов от других программ. К нему подключаются чат-боты, таблицы и CRM, если они умеют работать с API OpenAI. В Ollama адрес такого сервера — http://localhost:11434/v1/, ключ API можно указать любой: программа его не проверяет. Подключённая программа отправляет запросы так же, как в OpenAI, и получает ответ от модели на вашем компьютере.
Проверить, что сервер работает, можно одной командой в терминале. Она отправляет модели вопрос в том же формате, что и программы, которые вы будете подключать:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "gemma4:e4b", "messages": [{"role": "user", "content": "Привет! Ответь одним словом: работаешь?"}]}'
Если в ответ пришёл текст от модели, адрес и имя модели можно вписывать в настройки бота, плагина для таблиц или CRM. В LM Studio сервер включают переключателем на вкладке Developer, там же видно его адрес.
Так подключают, например, бота для ответов на типовые вопросы клиентов или скрипт, который каждое утро раскладывает новые заявки по темам. Для таких задач хватит модели на 16 ГБ, а платить за каждый запрос, как в облачном API, не нужно.
По умолчанию Ollama принимает запросы только с того же компьютера (адрес 127.0.0.1). Чтобы моделью пользовался весь офис, адрес меняют настройкой (переменной окружения) OLLAMA_HOST, а LM Studio умеет включать сервер для локальной сети.
Открывайте сервер модели только внутри офисной сети. Если компьютер с Ollama или LM Studio доступен из интернета, к модели сможет обратиться любой, кто найдёт адрес, и нагружать ваше железо своими запросами.
Какие задачи отдать локальной нейросети, а какие облачной?
Локальной модели отдают то, что связано с секретными данными или повторяется сотни раз в день: пересказ договоров, разбор заявок и отзывов, черновики ответов клиентам. Облачному чату оставляют задачи, где нужны свежие факты из интернета, сложная аналитика или картинки. Мы свели типичные задачи в таблицу:
| Задача | Где делать | Почему |
|---|---|---|
| Пересказ договора, выписка штрафов и сроков | локально | документ не уходит из компании |
| Разбор 500 отзывов или заявок по темам | локально | много однотипных запросов, в облачном API платили бы за каждый |
| Ответы клиентам по шаблону | локально | хватает модели на 16 ГБ |
| Распознать текст со скана или фото | локально, модели с «зрением» | Gemma 4 и Qwen3.5-3.8 понимают картинки |
| Обзор рынка, свежие цены конкурентов | в облаке | у локальной модели нет поиска в интернете |
| Сложный отчёт или стратегия на десятки страниц | в облаке | большой модели проще держать длинную логику |
| Картинки для соцсетей и рекламы | в облаке или в отдельной программе | Ollama и LM Studio работают с языковыми моделями, картинки рисуют другие программы |
Деление условное: с несекретными данными облачный чат почти всегда ответит лучше, а с секретными локальная модель среднего размера закроет большую часть офисной рутины.
Какие ошибки делают новички с локальными нейросетями?
Самая частая ошибка — скачать самую большую модель, которая формально помещается в память. Компьютер начинает тормозить, ответ на простой вопрос идёт минуту, и человек решает, что локальные нейросети не работают. Начинайте с модели, файл которой меньше памяти хотя бы в полтора раза, и поднимайтесь на размер выше, только если качества не хватает.
Модель из старой инструкции. Llama 3, Mistral 7B и Qwen2.5 из статей 2024 года устарели, замены перечислены в списке выше. Перед скачиванием смотрите дату обновления в каталоге.
Модель работает на процессоре, хотя видеокарта есть. На Windows Ollama использует видеокарты NVIDIA с драйвером 551.61 и новее. Со старым драйвером программа может не увидеть видеокарту, и модель пойдёт на процессоре, а это заметно медленнее. Перед установкой обновите драйвер.
Фото в модель без «зрения». Скан договора текстовой модели не прочитать. Для сканов, фото товаров и скриншотов берите Gemma 4 или Qwen версий 3.5-3.8.
Длинный документ без настройки. В Ollama по умолчанию модель держит в голове около 4 тысяч токенов (кусочков слов), это несколько страниц. Договор на 30 страниц обрежется без предупреждения, поэтому перед работой с большими файлами в настройках увеличивают длину контекста, то есть сколько текста модель видит за раз.
Чем локальная нейросеть хуже ChatGPT?
По нашей оценке, локальная модель слабее флагманских облачных в сложных задачах и длинных рассуждениях. На ноутбуке работает модель на 4-30 млрд параметров, а в облаке — модели на сотни миллиардов параметров и больше: например, полная DeepSeek R1 — это 671 млрд. Ещё у локальной модели нет поиска в интернете и свежих знаний: она знает только то, чему её научили до выпуска.
На слабом железе есть и бытовые неудобства. Ответы идут медленнее, чем в облаке, и ноутбук под нагрузкой греется. Несколько моделей по 10-20 ГБ к тому же быстро съедают место на диске. Как делить задачи между локальной моделью и облаком, показано в таблице выше.
Не каждая модель в Ollama и LM Studio работает у вас на компьютере. В Ollama облачные модели заканчиваются на :cloud, в каталоге LM Studio помечены Cloud: их запросы уходят на серверы. Если вы ставите нейросеть ради приватности, выбирайте только локальные версии, а в Ollama облачные модели можно отключить совсем переменной OLLAMA_NO_CLOUD=1.
Частые вопросы
Можно ли бесплатно использовать локальную нейросеть в бизнесе?
Да, если у модели свободная лицензия. Gemma 4, Qwen версий 3.5-3.8, gpt-oss, Ministral 3 и Muse Glimmer выложены под Apache 2.0, DeepSeek R1 — под MIT: обе лицензии разрешают коммерческое использование без отчислений. Ollama и LM Studio тоже бесплатны для работы. Платите только за компьютер и электричество.
Видит ли Ollama или LM Studio мои запросы?
Нет, пока модель работает на вашем компьютере. Ollama в документации пишет, что не видит запросы и данные при локальной работе, LM Studio — что набранное в чате не покидает устройство. Исключение — облачные модели: в Ollama у них окончание :cloud, в LM Studio пометка Cloud. Их запросы уходят на серверы.
Какую локальную модель скачать первой?
На ноутбуке с 16 ГБ памяти начните с Gemma 4 E4B или Qwen3.5 9B: файлы весят 6,6-9,5 ГБ, обе понимают картинки и много языков, включая русский. На компьютере с 32 ГБ попробуйте Gemma 4 31B или Qwen3.8 27B. Прогоните одни и те же пять рабочих задач на двух моделях и оставьте ту, что ответила лучше.
Можно ли поставить одну модель на весь офис?
Да. Модель ставят на один мощный компьютер, а сотрудники подключаются к нему по офисной сети. В Ollama для этого меняют адрес настройкой OLLAMA_HOST, в LM Studio включают сервер на вкладке Developer. Учтите, что одновременные запросы нескольких человек замедляют ответы, поэтому под офис берут компьютер с запасом памяти.
Источники
- Ollama — каталог моделей
- Ollama — gemma4
- Hugging Face — Gemma 4 31B
- Ollama — gpt-oss
- Ollama Blog — OpenAI gpt-oss
- Ollama — deepseek-r1
- Ollama — модели DeepSeek
- Ollama — модели Llama
- Ollama — qwen3.5
- Ollama — qwen3.8
- LM Studio — каталог моделей
- Hugging Face — Ministral 3 8B
- LM Studio — Muse Glimmer
- LM Studio Docs — Offline Operation
- LM Studio Docs — System Requirements
- LM Studio Blog — Free for use at work
- Ollama Docs — FAQ
- Ollama Docs — OpenAI compatibility
- Ollama Docs — macOS
- Ollama Blog — Ollama's new app
- Ollama — qwen3.6
- Ollama — модели Mistral
- LM Studio Docs — Local server
- Ollama Docs — Windows
- Ollama Docs — GPU
- GitHub — ollama/ollama
- GitHub — GPT4All releases
- Jan
- ChatGPT — тарифы
- Курс ЦБ РФ на 07.11.2026 (зеркало cbr-xml-daily)
Пишет о нейросетях и продвижении в них для предпринимателей и маркетологов. Каждый гайд проверяет руками, цены сверяет по официальным страницам.