Открытые модели Qwen от Alibaba бесплатно ставятся на Windows, Mac и Linux через LM Studio (без командной строки) или Ollama (одной командой). Главное ограничение — память: модель должна целиком поместиться в оперативную память или память видеокарты, с запасом. При 8 ГБ подойдёт Qwen3.5 4B, при 16 ГБ — Qwen3.5 9B, при 32 ГБ и больше — Qwen3.6 35B или Qwen3.8 27B. В тестах Alibaba на русском языке модели прошлого поколения Qwen3 на 0.6B и 1.7B набирали заметно меньше баллов, поэтому для работы с текстами лучше брать модель от 4B.
Qwen можно бесплатно запустить на обычном компьютере. Alibaba выкладывает открытые версии своих моделей, их скачивают через программы LM Studio или Ollama, и дальше нейросеть отвечает без интернета и подписки. Мощная видеокарта необязательна, но памяти нужно от 8 ГБ, а для моделей посильнее — от 16 ГБ.
Этот гайд — про установку на свой компьютер. Что такое Qwen, сколько стоят облачный чат и подписки, мы разобрали в обзоре Qwen.
Можно ли запустить Qwen на обычном компьютере?
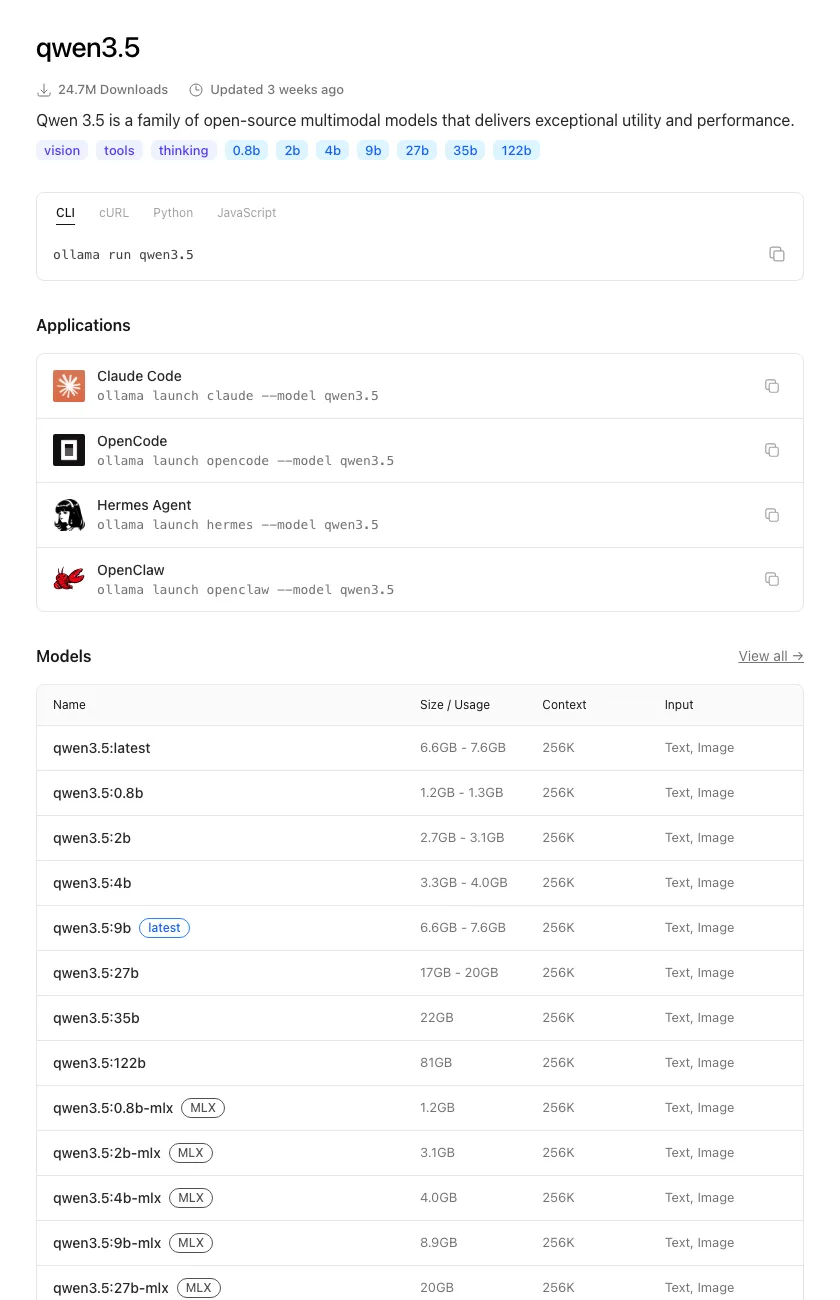
Можно, если взять модель под размер вашей памяти. Модели различаются числом параметров: это числа внутри нейросети, которые настроили при обучении. Чем их больше, тем модель умнее и тем тяжелее её файл. У Qwen есть открытые модели от крошечной на 0,8 млрд параметров (файл чуть больше 1 ГБ) до гигантов на сотни миллиардов, которым нужен сервер.
Ноутбуку подходят модели на 4-9 млрд параметров, Mac с 32 ГБ памяти или компьютеру с видеокартой на 24 ГБ — на 27-35 млрд. Подробнее, как устроены языковые модели, мы рассказали в статье что такое LLM.
Свой Qwen нужен, когда документы нельзя отправлять в чужое облако, например договоры или базу клиентов. Ещё он выручает без стабильного интернета и в случаях, когда однотипных запросов так много, что в облаке пришлось бы платить за каждый.
Какой компьютер нужен для Qwen локально?
Главное требование — память. Модель должна целиком поместиться в оперативную память или в память видеокарты, иначе часть работы уходит на процессор и ответы заметно замедляются. Сверх размера файла нужен запас: память занимают система, браузер и сама переписка с моделью.
Мы свели размеры файлов из каталога Ollama. Это сжатые версии, которые программа скачивает сама: сжатие (его называют квантованием) уменьшает файл в несколько раз ценой небольшой потери точности.
| Память компьютера | Какую модель брать | Размер файла |
|---|---|---|
| 8 ГБ | Qwen3.5 4B | 3,3-4 ГБ |
| 16 ГБ | Qwen3.5 9B | 6,6-7,6 ГБ |
| 24 ГБ видеопамяти (RTX 3090, 4090) | Qwen3.8 27B | 18 ГБ |
| 32 ГБ и больше (Mac или ПК) | Qwen3.6 35B или Qwen3.8 27B | 23 ГБ / 18 ГБ |
| 64 ГБ и больше | Qwen3.8 27B в версии q8 (сжата меньше, отвечает чуть точнее) | 30 ГБ |
На компьютере с Windows и отдельной видеокартой считайте память видеокарты: модель, которая влезает в неё целиком, работает заметно быстрее. На видеокарте RTX 3090 с 24 ГБ памяти Qwen3.8 27B запускают локально, подробный разбор есть на Хабре. На Mac с чипами M1 и новее графика встроена в чип и пользуется общей памятью, поэтому MacBook на 32 ГБ тянет модели, которым на Windows нужна дорогая видеокарта.
Требования самих программ на ноябрь 2026 года:
| LM Studio | Ollama | |
|---|---|---|
| Mac | чип M1-M4, macOS 14 и новее, рекомендовано 16 ГБ памяти; Mac на Intel не поддерживается | macOS 14 Sonoma и новее; на Mac с Intel работает только процессор |
| Windows | процессор с набором команд AVX2 (если программа не запускается, дело может быть в нём) или ARM (Snapdragon X Elite); рекомендовано 16 ГБ памяти и 4 ГБ видеопамяти | Windows 10 22H2 и новее; для видеокарт NVIDIA — драйвер 551.61 и новее |
| Linux | Ubuntu 20.04 и новее | команда curl -fsSL https://ollama.com/install.sh | sh |
Видеокарты NVIDIA Ollama поддерживает от старой GTX 750 Ti до RTX 5090. Без видеокарты Ollama тоже работает, на процессоре.
Как узнать свою память. В Windows нажмите Ctrl + Shift + Esc, откройте «Производительность» → «Память», там же во вкладке видеокарты (GPU) — «Выделенная память». На Mac: меню Apple → «Об этом Mac», строка «Память».
Какую модель Qwen выбрать для ноутбука?
Берите самую свежую линейку, которая помещается в вашу память по таблице выше. Модели прошлых поколений Qwen3 и Qwen2.5, которые до сих пор советуют многие инструкции и чат-боты, уже устарели. На ноябрь 2026 года на компьютер ставят три линейки:
- Qwen3.5 (февраль 2026) — размеры 0.8b, 2b, 4b, 9b, 27b, 35b, 122b. Понимает текст и картинки, по описанию Alibaba знает 201 язык и диалект. Самый широкий выбор для слабого железа.
- Qwen3.6 (апрель 2026) — 27b и 35b, по описанию в каталоге Ollama сильнее предшественниц в программировании. Версия 35B устроена как «смесь экспертов»: из 35 млрд параметров на каждое слово работают только 3 млрд. Файл весит 23 ГБ, но вычислений на каждое слово у неё меньше, чем у обычной 27B.
- Qwen3.8 27B (август 2026) — самая свежая из трёх линеек в каталогах Ollama и LM Studio, понимает картинки и видео. Файл 18 ГБ.
Все три линейки выложены под лицензией Apache 2.0. Модель можно бесплатно использовать в работе компании и встраивать в свои сервисы без отчислений Alibaba. Для сравнения с другими китайскими моделями — наш рейтинг китайских нейросетей.
Как установить Qwen без командной строки через LM Studio
LM Studio — бесплатная программа с привычным окном чата, команды вводить не нужно. С июля 2025 года её разрешено бесплатно использовать и дома, и на работе. На всё уходит 15-25 минут, большая часть — на скачивание модели.
Скачайте и установите LM Studio ≈ 5 мин
- Сайт lmstudio.ai, версия для Windows, Mac или Linux
- Установите как обычную программу и откройте
Найдите модель Qwen ≈ 2 мин
- Откройте раздел поиска моделей
- Введите Qwen3.5 и выберите размер по таблице памяти
Скачайте модель ≈ 5-15 мин
- Если вариантов файла несколько, берите сжатый Q4: он легче, а для обычных задач точности хватает
- Нажмите Download и дождитесь загрузки файла на 3-8 ГБ, интернет нужен только на этом шаге
Начните разговор ≈ 1 мин
- Перейдите в чат и выберите скачанную модель вверху окна
- Задайте первый вопрос, первая загрузка модели в память займёт несколько секунд
Как запустить Qwen через Ollama одной командой
В Ollama Qwen запускается одной командой, программа тоже бесплатная. Скачайте установщик с ollama.com: на Mac перетащите приложение в «Программы», на Windows запустите OllamaSetup.exe, права администратора не нужны. Потом откройте Терминал на Mac или командную строку в Windows (Win + R → cmd) и введите команду под свою память:
| Память | Команда | Что скачается |
|---|---|---|
| 8 ГБ | ollama run qwen3.5:4b | Qwen3.5 4B, 3,3-4 ГБ |
| 16 ГБ | ollama run qwen3.5:9b | Qwen3.5 9B, 6,6-7,6 ГБ |
| 24 ГБ видеопамяти или 32 ГБ на Mac | ollama run qwen3.8 | Qwen3.8 27B, 18 ГБ |
| 32 ГБ и больше, если нужен код | ollama run qwen3.6:35b | Qwen3.6 35B, 23 ГБ |
Первый запуск скачивает модель, следующие открывают её сразу. Ответы приходят прямо в окне терминала. Тем, кому удобнее обычное окно чата, подойдёт приложение Ollama для Mac и Windows, оно вышло в июле 2025 года: в него можно перетащить PDF или текстовый файл и спросить по нему.
Проверить, где работает модель, можно командой ollama ps в соседнем окне. В колонке Processor надпись «100% GPU» означает, что модель целиком в памяти видеокарты. Если там «48%/52% CPU/GPU», модель не поместилась и часть работы делает процессор, так что лучше взять размер поменьше.
Модели лежат в папке .ollama в домашней папке пользователя. На Windows их можно перенести на другой диск: в поиске меню «Пуск» наберите «переменные среды», откройте «Изменение переменных среды текущего пользователя», создайте переменную OLLAMA_MODELS с путём к новой папке и перезапустите Ollama.
Насколько хорошо локальный Qwen понимает русский?
Модели Qwen от 4 млрд параметров справляются с русским заметно лучше меньших, по крайней мере в тестах прошлого поколения. В отчёте Alibaba о Qwen3 (май 2025) у модели 4B средний балл по русскому 53,9 из 100, у 1.7B — 31,8. В таблице средний балл по четырём тестам (следование инструкциям, общие знания и две задачи по математике) в режиме рассуждений, когда модель сначала пишет ход мыслей, а потом ответ:
Модель на 14 млрд параметров отстала от серверной на 235 млрд меньше чем на 5 баллов, а Gemini 2.5 Pro в той же таблице набрал 67,7. По нашей оценке, для писем и черновиков разрыв между средней локальной моделью и серверной тоже небольшой.
Без режима рассуждений баллы ниже: 34,0 у 4B и 40,2 у 8B. У 8B это близко к GPT-4o с 41,5 в той же таблице. Цифры относятся к Qwen3. В карточке Qwen3.5 на Hugging Face многоязычные тесты даны средним баллом по десяткам языков, отдельной строки для русского там нет. Поэтому перед работой проверьте модель на своих задачах, хватит трёх вопросов:
1. Перескажи этот текст в трёх предложениях простым языком: [вставьте абзац из своего документа]

2. Напиши вежливый ответ клиенту, который просит скидку 20%. Мы можем дать только 10% и бесплатную доставку.

3. В магазине было 120 товаров. В понедельник продали треть, во вторник — четверть остатка. Сколько товаров осталось? Объясни решение.
Пересказ проверяет понимание, письмо клиенту — стиль и грамматику, задача — логику (правильный ответ 60). Если модель путает падежи или ошибается в задаче, возьмите размер побольше.
Бесплатный мастер-класс · онлайнХотите, чтобы нейросеть делала рутину в вашем бизнесе? На бесплатном вебинаре показываем, какие задачи отдать ИИ и как настроить его под себя.
Записаться бесплатно →Чем локальный Qwen хуже облачного чата?
Локальный Qwen слабее облачного в сложных задачах и умеет меньше: у него нет поиска в интернете и генерации картинок. Зато он бесплатный. На ноутбуке работает модель на 4-35 млрд параметров, а у самой большой модели семейства, Qwen3.8-Max, по данным Alibaba 2,4 трлн параметров, и её запускают только на серверах.
Локальный Qwen уступает
- в сложной логике и коде: модель в десятки раз меньше серверной
- в свежих фактах: знает только то, чему её научили
- на слабом железе: отвечает медленно, ноутбук греется и шумит
Локальный Qwen выигрывает
- переписка и файлы остаются на компьютере
- работает без интернета и без лимитов на число запросов
- модель не обновят и не отключат без вашего ведома
Если документы не секретные и нужен лучший результат, удобнее бесплатный облачный чат Qwen или другие сервисы из подборки аналогов ChatGPT.
Какие задачи отдать локальному Qwen?
Лучше всего локальный Qwen справляется с пересказом документов, черновиками писем клиентам и разбором пачек отзывов или заявок по темам. Свежие данные из интернета для таких задач не нужны. Мы прикинули, какой модели хватит для каждой задачи:
| Задача | Пример | Какая модель справится |
|---|---|---|
| Пересказ документов | выжимка из договора, протокола встречи, длинного письма | Qwen3.5 9B и выше, если увеличить длину контекста (как — в разделе о том, что делать, если Qwen тормозит) |
| Черновики писем и ответов | ответы клиентам по шаблону, вежливый отказ, напоминание об оплате | Qwen3.5 4B и выше |
| Разбор обращений | разложить 200 отзывов или заявок по темам и тональности | Qwen3.5 9B и выше |
| Работа с картинками | прочитать текст со скана, описать фото товара | Qwen3.5, Qwen3.6 и Qwen3.8: все понимают изображения |
| Код и таблицы | формулы для Excel, простые скрипты | Qwen3.6 35B или Qwen3.8 27B |
Готовые формулировки для таких задач ищите в подборке промтов для бизнеса. Для работы с договором промт лучше строить так, чтобы модель отвечала только по тексту, который вы дали:
Ниже текст договора. Отвечай только по этому тексту, ничего не додумывай.
Если ответа в тексте нет, так и напиши: «В договоре этого нет».

1. Кто стороны договора и какой у него срок?
2. Какие штрафы и за что предусмотрены?
3. Как и за сколько дней можно расторгнуть договор?

[текст договора]
Нейросети склонны додумывать недостающие детали, и фраза «ничего не додумывай» это сдерживает. Цифры, даты и суммы из ответа всё равно сверяйте с документом.
Что делать, если Qwen тормозит или отвечает странно?
Чаще всего виновата слишком большая модель: она не поместилась в память, и часть работы перешла на процессор. Проверьте это командой ollama ps, возьмите размер поменьше или закройте браузер и другие тяжёлые программы.
Модель долго «думает» перед ответом. Qwen3.5 и Qwen3.8 по умолчанию включают режим рассуждений: сначала пишут ход мыслей, потом ответ. Сложной задаче это помогает, а простое письмо из-за рассуждений приходится ждать дольше. Если в программе есть переключатель рассуждений, выключайте его для коротких поручений.
Модель «забывает» начало длинного документа. В Ollama длина контекста, то есть сколько текста модель держит в голове за раз, по умолчанию 4 096 токенов (токен — кусок слова). Это несколько страниц. Сами модели Qwen рассчитаны на 256 тысяч токенов, но без настройки длинный договор обрежется. В приложении Ollama длину контекста увеличивают в настройках, в терминале — командой /set parameter num_ctx 32768 прямо в чате. Памяти на это уйдёт больше.
Первый ответ после паузы идёт медленно. Ollama держит модель в памяти 5 минут после последнего вопроса, потом выгружает. Следующий запрос снова загружает файл с диска, это несколько секунд, дальше скорость обычная.
Модели с окончанием :cloud в названии в Ollama работают на серверах компании: запросы уходят с вашего компьютера. Если вы ставите Qwen ради приватности, выбирайте версии без этого окончания. Отключить облачные модели совсем можно переменной OLLAMA_NO_CLOUD=1.
Не хватает места на диске. Каждая модель — отдельный файл на гигабайты. В Ollama лишнюю удаляет команда ollama rm с именем модели, например ollama rm qwen3.5:4b. В LM Studio модели удаляются в разделе со списком скачанных.
Частые вопросы
Нужен ли интернет, чтобы пользоваться Qwen локально?
Только чтобы скачать программу и файл модели. Дальше Qwen отвечает без сети, все расчёты идут на вашем компьютере, и Ollama в документации прямо пишет, что при локальной работе не видит ваши запросы. Интернет снова понадобится, если вы захотите скачать другую модель или обновить программу.
Можно ли бесплатно использовать локальный Qwen в бизнесе?
Да. Лицензия Apache 2.0, под которой выложены Qwen3.5, Qwen3.6 и Qwen3.8 27B, разрешает коммерческое использование без отчислений Alibaba. Сами программы тоже бесплатны для работы. Платить придётся только за компьютер и электричество, а при большой нагрузке, возможно, за более мощную видеокарту.
Сколько места на диске нужно для Qwen?
От 1 до 30 ГБ на одну модель плюс сама программа. Самая маленькая Qwen3.5 0.8B весит около 1,2 ГБ, Qwen3.5 9B — 6,6-7,6 ГБ, Qwen3.6 35B — 23 ГБ, версия q8 у Qwen3.8 27B, которая сжата меньше, — 30 ГБ. Установщику Ollama для Windows нужно ещё около 4 ГБ. Если пробуете несколько моделей, лишние удаляйте.
Запустится ли Qwen на ноутбуке без видеокарты?
Да, но медленнее. На ноутбуке без отдельной видеокарты лучше брать Qwen3.5 4B или 9B и не ждать мгновенных ответов на длинные вопросы. Если ноутбук часто нужен для такой работы, выгоднее Mac на чипе M-серии с 16-32 ГБ памяти: его встроенная графика берёт общую с процессором память, отдельная видеокарта не нужна.
Источники
- Ollama — qwen3.5
- Ollama — qwen3.6
- Ollama — qwen3.8
- Ollama — Download
- Ollama Docs — macOS
- Ollama Docs — Windows
- Ollama Docs — GPU
- Ollama Docs — FAQ
- Ollama Blog — Ollama's new app
- LM Studio Docs — System Requirements
- LM Studio — Models
- LM Studio Blog — Free for use at work
- Hugging Face — Qwen3.5-9B
- Hugging Face — Qwen3.6-35B-A3B
- Hugging Face — Qwen3.8-27B
- Qwen Blog — Qwen3.8-Max
- Hugging Face — Qwen3.8-2.4T-A95B
- Qwen3 Technical Report (arXiv 2505.09388), таблица 32
Пишет о нейросетях и продвижении в них для предпринимателей и маркетологов. Каждый гайд проверяет руками, цены сверяет по официальным страницам.