Как выяснили учёные NYU и UT Austin (октябрь 2026 года), сильные нейросети, в том числе Claude и GPT-5.6, чаще людей пишут так, будто предмет действует сам («данные говорят»), и соединяют слова, которые люди вместе почти не употребляют. Заподозрить нейросеть можно по этим приметам, выдуманным цифрам и ссылкам и по отсутствию деталей, которые знает только автор, а доказать нельзя: так пишут и люди. Приметы убирает правка: подлежащее ставим рядом со сказуемым, а того, кто действует, называем прямо.
Текст нейросети часто грамотный и при этом утомительный: дочитываешь абзац и не помнишь, о чём он. В октябре 2026 года лингвисты из Нью-Йоркского университета (NYU) и Техасского университета в Остине (UT Austin) нашли шесть причин этой усталости, и все они в том, как построены предложения. Ниже разбираем каждую на русских примерах, а потом даём способ проверить чужой текст, промт для правки и чек-лист.
Слова-штампы вроде вступлений про современный мир мы разобрали в гайде о том, как писать тексты нейросетью без штампов. Эта статья о том, как построены предложения: текст без единого штампа всё равно бывает тяжёлым.
Какие шесть признаков ИИ-текста нашли учёные
Учёные нашли шесть примет: редкие сочетания слов, подлежащее далеко от сказуемого, цепочки оборотов (в работе — сжатые придаточные), цепочки существительных, глаголы из существительных и предметы, которые действуют как люди. По работам психолингвистов, такие приёмы затрудняют понимание. Авторы посчитали, как часто их используют нейросети и люди.
| Признак | Что это | Пример из работы (английский) |
|---|---|---|
| Редкие сочетания слов | Пары и тройки слов, которых почти не бывает в текстах людей | reader-patience budget — «бюджет терпения читателя» |
| Подлежащее далеко от сказуемого | Связанные слова, например подлежащее и сказуемое, стоят далеко друг от друга | Подлежащее, а за ним длинный оборот до сказуемого |
| Цепочки оборотов (сжатые придаточные) | Придаточное без связующего слова: the house the contractors built без that | «Дом, который построили подрядчики» без «который» |
| Цепочки существительных | Три и больше существительных подряд, связь между ними читатель угадывает | Заголовок Squad Helps Dog Bite Victim: то ли команда помогает жертве укуса, то ли помогает собаке укусить |
| Глаголы из существительных | Существительное работает как глагол | Лингвистический пример calendar it — «закалендарь это» вместо «внеси в календарь» |
| Предмет действует как человек | Неживое подлежащее с глаголом, который подходит человеку | is_file() swallows that — функция «проглатывает» ошибку |
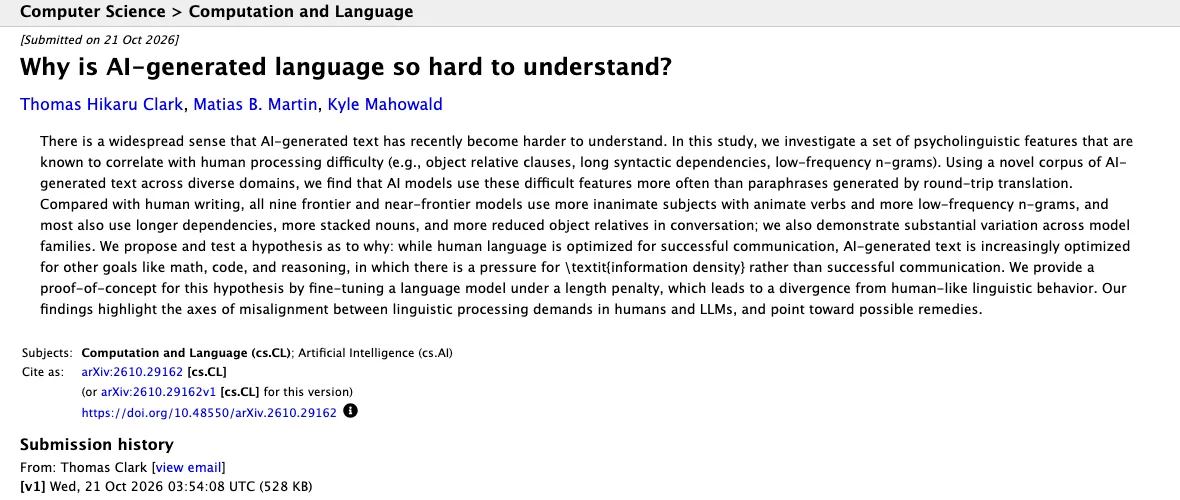
Работу написали Томас Хикару Кларк (NYU), Матиас Мартин и Кайл Махоулд (UT Austin). Её выложили 21 октября 2026 года на arXiv, сайт, где учёные публикуют работы до проверки в журнале. Другие учёные её ещё не рецензировали.
Для сравнения взяли тексты 14 моделей: Claude Sonnet 5, Opus 5, Opus 5.5 и Fable 5, три версии GPT-5.6, Kimi K2.5 и GLM 5, которые можно скачать и запустить у себя, а также небольшие Llama 3.1 (две версии) и Olmo 3 (три версии). Набралось 120 разговоров, 45 задач по программированию в настоящих проектах и 980 эссе. Тексты людей брали из субтитров к фильмам, с форума программистов StackExchange, из сочинений школьников и из Википедии.
Главный приём метода — обратный перевод. Каждое предложение модели переводили на японский и обратно на английский: смысл тот же, а формулировка становится более обычной. Если трудный оборот после такого перевода встречается реже, значит, простой вариант был, а модель выбрала сложный сама. Для проверки опыт повторили и с русским языком-посредником.
Надёжнее всего авторы показали две приметы. Все девять самых сильных из 14 моделей чаще людей ставят неживое подлежащее с «живым» глаголом и соединяют редкие сочетания слов. Большинство из них в разговоре ещё и далеко разносят связанные слова, складывают цепочки существительных и пишут сжатые придаточные. Глаголы из существительных в текстах моделей встречаются чаще, чем в тех же текстах после обратного перевода; с людьми этот признак сравнивали только в эссе.
Почему мощные нейросети пишут тяжелее
По гипотезе авторов, причина в том, на чём модели доучивают. После основного обучения их тренируют на задачах по математике, программированию и рассуждениям: программа проверяет ответ и поощряет модель за верный. Понятно ли написан текст, там никто не смотрит, и модель привыкает упаковывать как можно больше смысла в как можно меньше слов.
С догадкой согласуется то, что видно у Olmo: у неё есть три версии. Базовая, которую научили только продолжать текст, почти не показывает этих примет, как и Llama. У версии, обученной отвечать на вопросы, их больше. У Olmo Think, которая сначала рассуждает, а потом отвечает, их уже столько же, сколько у самых сильных моделей.
Гипотезу проверили и опытом. Небольшую модель Qwen2.5-1.5B доучили со штрафом за длину ответа. Без сдерживающей настройки модель почти всегда, больше чем в 98% случаев, выбирала короткий вариант фразы. Это касается двух конструкций, на которых её учили. Часть этой привычки модель перенесла на обороты, которых в обучении не было.
Издание The Decoder приводит похожее объяснение Джексона Керниона, который в Anthropic занимается дообучением Claude. По его словам, Claude стал писать плотно и неестественно, потому что его много учили на математике, коде и технических текстах для других нейросетей.
Claude Opus 5.5 реже предшественника Opus 5 использует трудные обороты: так вышло в 19 сравнениях из 21. Авторы пишут, что модели можно поощрять и за понятный текст. По Opus 5.5 видно, что новая версия может писать проще старой.
Как шесть признаков выглядят в русском тексте
В русских текстах нейросетей похожие приёмы встречаются, только выглядят иначе: цепочки слов в родительном падеже, нагромождение причастных оборотов, «данные говорят». Исследование сделано только на английском, поэтому его цифры на русские тексты не переносятся. Примеры ниже составили мы: сначала типичная фраза в духе нейросети, потом та же мысль, переписанная для человека.
1. Редкие и странные сочетания слов
Нейросеть соединяет слова, которые люди вместе почти не употребляют. Чаще всего это метафоры из финансов и IT там, где можно сказать прямо. Каждое такое сочетание читатель расшифровывает и тратит на это внимание.
Как пишет нейросеть: «Длинное вступление списывает кредит доверия читателя и увеличивает трение на пути к заявке». Как переписать: «Из-за длинного вступления люди закрывают страницу и не доходят до формы заявки».
2. Подлежащее далеко от сказуемого
Пока читатель не дошёл до сказуемого, он держит подлежащее в голове. Если между ними два оборота и придаточное, к концу фразы он забывает начало и перечитывает.
Как пишет нейросеть: «Менеджер, который после того как клиент, получивший заказ с опозданием на два дня, оставил жалобу, позвонил ему в течение часа, получил премию». Как переписать: «Клиент получил заказ на два дня позже и оставил жалобу. Менеджер перезвонил ему в течение часа и получил за это премию».
3. Цепочки оборотов вместо простого «который»
В английском модели часто опускают связующее «that». По-русски «который» выбросить нельзя, и сжатие выглядит иначе: причастный оборот цепляется за причастный, а в конце висит деепричастный. Нагромождение причастных оборотов редакторы русской Википедии тоже записали в признаки сгенерированного текста.
Как пишет нейросеть: «Подготовленный отделом по итогам проведённой в мае проверки отчёт, направленный руководству, содержит рекомендации, подчёркивая важность изменений». Как переписать: «В мае отдел провёл проверку и отправил руководству отчёт. В нём написано, что нужно изменить и почему».
4. Цепочки существительных
Английская цепочка — три-четыре существительных подряд без предлогов. По-русски они выстраиваются в цепочку родительного падежа: каждое следующее слово зависит от предыдущего, и к концу непонятно, что к чему относится.
Как пишет нейросеть: «Внедрение системы автоматизации обработки заявок клиентов отдела продаж». Как переписать: «Мы подключаем программу, которая сама разбирает заявки клиентов и передаёт их продавцам».
5. Глаголы из существительных
По-английски так получается «calendar it» вместо «внеси в календарь». Русский аналог — деловой сленг: «закалендарить созвон», «апрувнуть макет», «зашерить доступ». Если встретили такое в тексте для клиентов, замените обычным глаголом.
В исследовании этого нет, но читать мешает похоже: глагол прячут в существительное. «Провести оптимизацию» вместо «оптимизировать», «осуществить проверку» вместо «проверить». Читателю так же приходится искать, кто и что делает.
Как пишет нейросеть: «Предлагаем закалендарить встречу для проведения оценки текущего состояния». Как переписать: «Давайте встретимся и посмотрим, как у вас сейчас идут дела».
6. Предмет действует как человек
Эту примету авторы нашли у всех девяти сильнейших моделей. Функция «проглатывает» ошибку, песня «не просит», подход «съедает» бюджет. В русских текстах нейросетей то же самое: «данные говорят сами за себя», «рынок не прощает ошибок», «каждый абзац борется за внимание». Читатель не видит, кто на самом деле действует, и не понимает, что делать ему самому.
Как пишет нейросеть: «Ручная обработка заказов съедает маржу и тормозит рост». Как переписать: «Два сотрудника весь день вручную переносят заказы в таблицу. На их зарплату уходит заметная часть прибыли, а больше заказов они всё равно не успеют обработать».
Чем эти признаки отличаются от штампов
Штампы видны на уровне слов: важно отметить, уникальный, в эпоху цифровых технологий. Их можно найти поиском по тексту и вычеркнуть. Шесть примет из исследования поиском по словам не найти, их видно только при чтении.
Русскоязычный список примет ведут и редакторы Википедии. Их эссе «Признаки сгенерированности текста» перечисляет штампы, тройки однородных слов, двойные конструкции с не только и но и, причастные обороты и ссылки на неназванных экспертов. Эссе не считается правилом, и его авторы предупреждают: текст с такими приметами вполне мог написать человек.
Проверять текст удобнее в два прохода. Сначала вычистить штампы по нашей таблице с заменами, потом прочитать его ещё раз уже на шесть признаков.
Можно ли по этим признакам доказать, что текст написала нейросеть
Нет. Длинные цепочки существительных и причастные обороты встречаются в договорах, научных статьях и отчётах, которые люди писали задолго до нейросетей. Подлежащее за три строки до сказуемого — обычное дело для канцелярского текста.
Учёные в своей работе тоже не определяли, кто автор текста. Они сравнивали, как часто приёмы встречаются у моделей и у людей. Что такие приёмы мешают понимать текст, психолингвисты показали в прежних работах. Как быстро люди понимают именно такие фразы, авторы отдельно не замеряли.
Детекторы ИИ, которые обещают процент «машинности», принимают текст человека за машинный и наоборот. Почему так и как к текстам нейросетей относятся Google и Яндекс, мы разобрали в статье видят ли поисковики тексты от ИИ.
Как проверить чужой текст на ИИ
Прочитайте текст по шести признакам и штампам, сверьте цифры и ссылки, поищите детали, которые знает только автор, а если сомнение осталось, спросите автора. Так вы получите обоснованное подозрение, доказательства не будет. Одна примета ничего не значит. Если в одном абзаце сошлись несколько разных примет, присмотритесь к тексту внимательнее.
Потом сверьте цифры, цитаты и ссылки. Нейросеть уверенно придумывает исследования, названия законов и статистику, поэтому несуществующий источник — сильный сигнал, что текст никто не проверял. Поищите и то, что знает только автор: цены, сроки, случай из практики, свой вывод. Если таких деталей нет, текст без правок подошёл бы любой компании из той же ниши.
Если сомнение осталось, спросите автора, откуда взята цифра, или попросите черновик и план. Человек, который сам писал текст, обычно легко объясняет, почему поставил именно этот пример. Процент детектора добавьте к остальным сигналам, но решения по нему одному не принимайте. Если проверяете работу студента, заранее узнайте, разрешает ли вуз или колледж пользоваться нейросетями и как.
Как убрать признаки ИИ-текста промтом
Быстрее всего отдать текст нейросети-редактору с точным заданием: какие шесть признаков искать и как переписывать. В промте мы сначала просим список проблемных мест, потом правку. Так видно, что именно модель поменяла, и с правкой можно не согласиться.
Ты редактор. Найди в тексте ниже места, которые трудно читать, по шести признакам:
1. Редкие и странные сочетания слов, метафоры из IT и финансов там, где можно сказать прямо («бюджет внимания», «трение в воронке»).
2. Подлежащее далеко от сказуемого: между ними вставлен длинный оборот.
3. Цепочки причастных и деепричастных оборотов вместо простого «который» или отдельного предложения.
4. Цепочки из трёх и больше существительных подряд («система оценки эффективности работы отдела»).
5. Глаголы, сделанные из существительных или англицизмов («закалендарить», «апрувнуть»), и обратное: действие, спрятанное в существительное («провести оптимизацию»).
6. Неживой предмет, который ведёт себя как человек: «подход съедает бюджет», «рынок не прощает», «данные говорят».
Сначала выпиши каждое найденное место и номер признака. Потом перепиши текст: одно действие — одно предложение, подлежащее рядом со сказуемым, кто делает — назван прямо. Сохрани все факты и цифры, ничего не добавляй от себя. Если признаков нет, так и напиши.
Текст: [текст]
Мы проверили промт в ChatGPT. Сначала попросили написать абзац для блога логистической компании о том, почему интернет-магазину выгоднее отдать склад сторонней компании, потом вставили этот абзац в промт-редактор в новом чате.
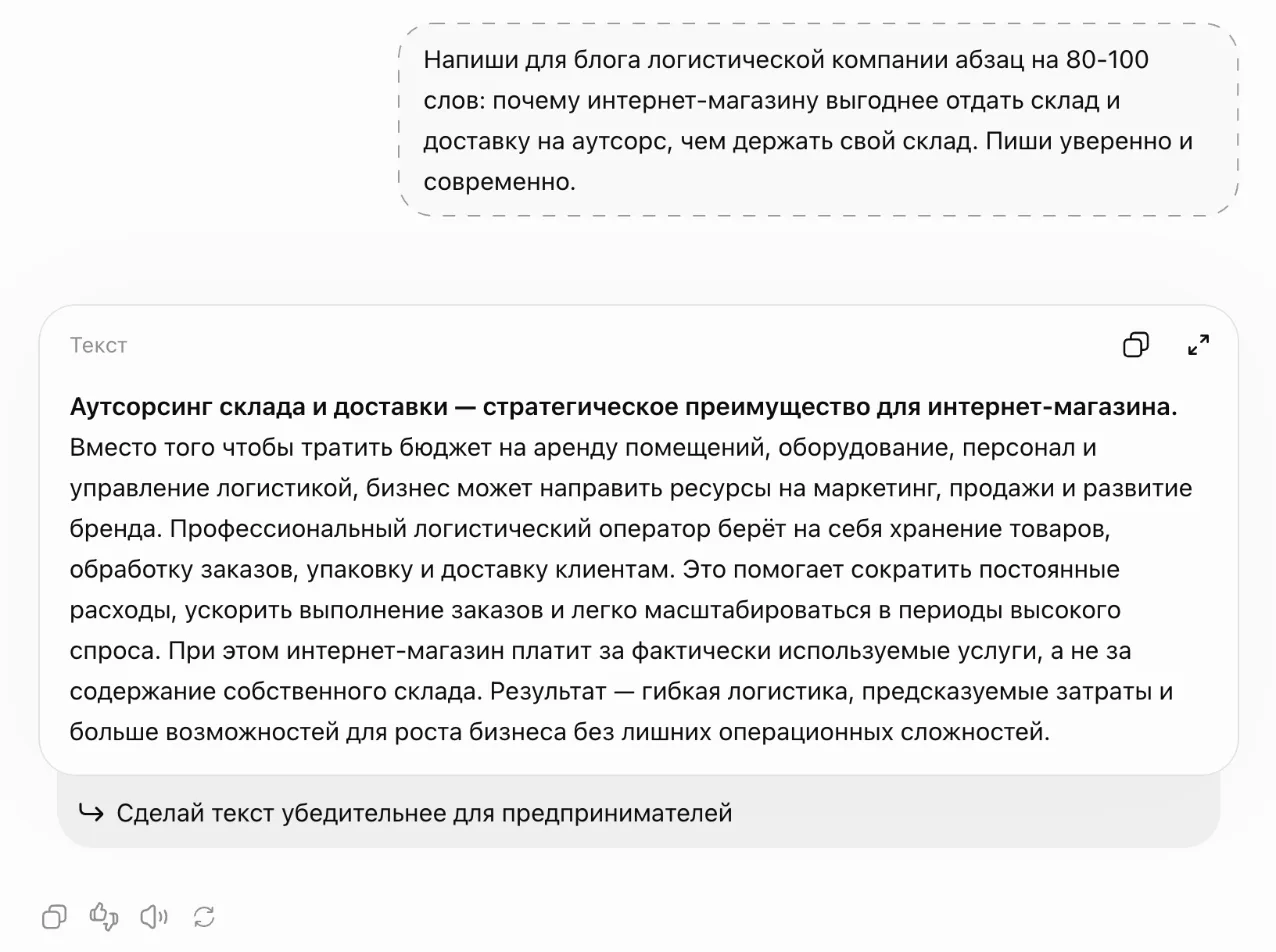
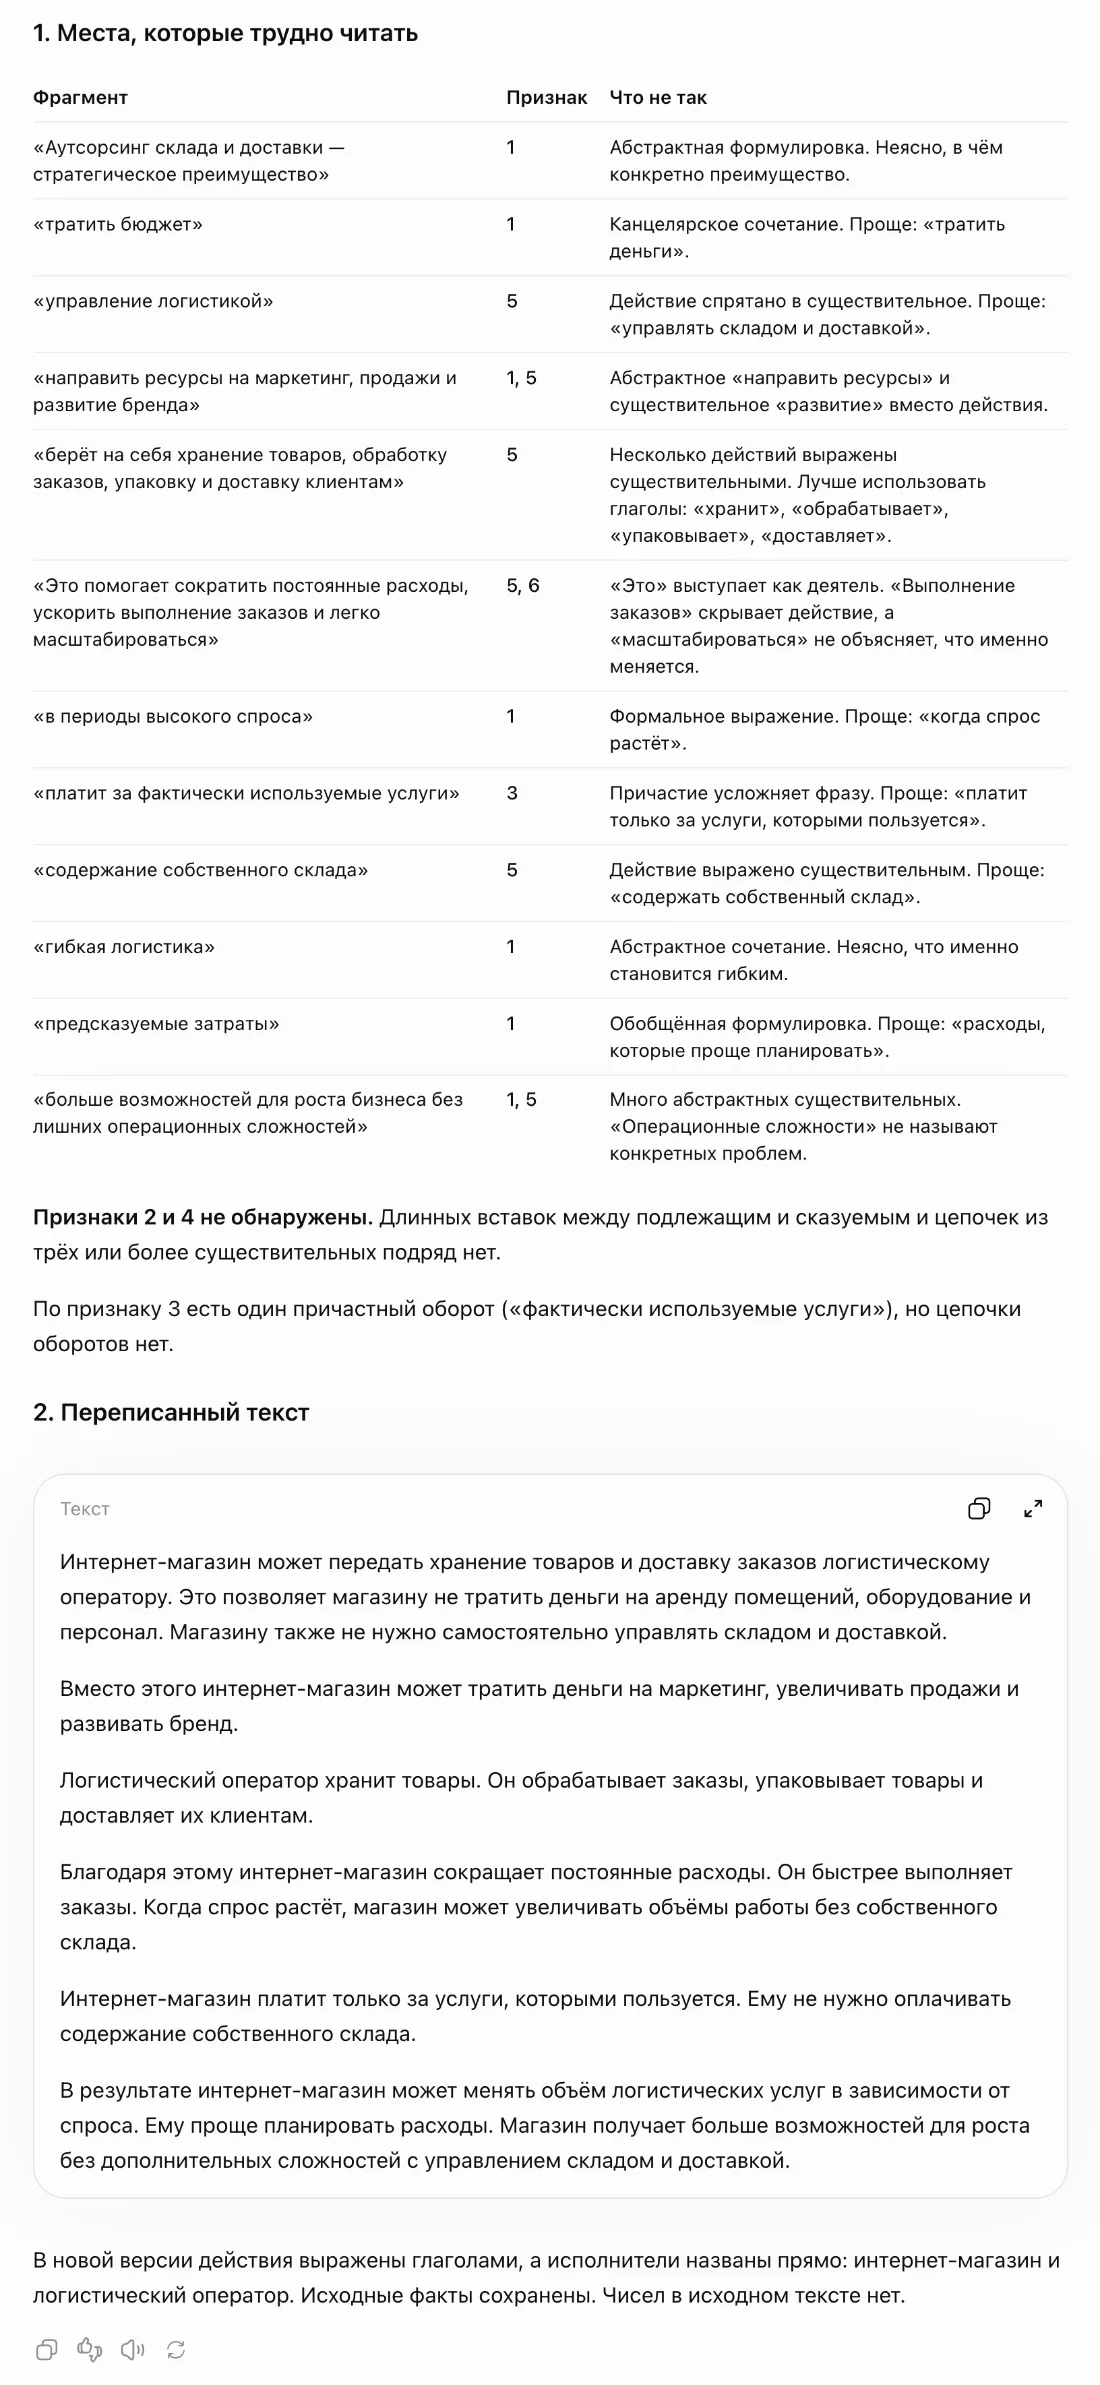
После редактора сверьте результат с исходником. В нашем примере ChatGPT убрал «стратегическое преимущество» и «гибкую логистику», но оставил «содержание собственного склада» и «больше возможностей для роста», хотя сам их отметил. Ещё он снова сделал «это» деятелем («Это позволяет магазину…»), выбросил слово «профессиональный» и добавил «увеличивать продажи», которого в исходнике не было. Переписывая, нейросеть может потерять цифру или условие, а иногда добавляет то, чего не было, хотя в промте это запрещено. Отдельно посмотрите на шестую примету: модель может заменить одну метафору другой. Если в переписанном тексте снова что-то «работает на вас» или «закрывает боль», отправьте его на второй круг или поправьте руками.
Длинный текст давайте редактору частями по три-четыре абзаца. Так модель внимательнее проходит каждую фразу, а вам проще сверить правку с исходником.
Как сразу получить черновик без этих признаков
Проще не допустить приметы, чем вычищать их потом. Для этого добавьте в промт черновика описание нужного стиля. Anthropic в документации по промтам советует говорить модели, что делать: одних запретов ей мало. Общую формулу промта мы разобрали в гайде о том, как писать промты, а этот блок можно дописать в конец любого задания.
Пиши так, как объясняешь человеку вслух. Одно действие — одно предложение. Подлежащее ставь рядом со сказуемым. Всегда называй, кто действует: человек, компания, отдел, а не «подход», «данные» или «рынок». Вместо цепочки из трёх существительных пиши глагол и «который». Не используй метафоры из IT и финансов, если можно сказать прямо. Если сомневаешься между коротким и понятным вариантом фразы, выбирай понятный.
Последнюю строку мы добавили из-за опыта с Qwen: модель, которую штрафовали за длину, без сдерживающей настройки почти всегда выбирала короткий вариант оборота, хотя люди выбирают его по ситуации, а понятный вариант часто чуть длиннее.
Чек-лист правки ИИ-текста
Перед публикацией прочитайте свой текст по этому списку, на страницу уходит пять-десять минут. По нему проверяются и шесть признаков из исследования, и частые ошибки нейросетей.
- Прочитайте каждый абзац вслух. Где пришлось перечитать фразу, там одна из шести примет.
- Если между подлежащим и сказуемым больше десяти слов, разбейте фразу.
- Посчитайте обороты: два причастных или деепричастных в одном предложении — уже повод переписать.
- Ищите цепочки из трёх и больше слов в родительном падеже и разворачивайте их через глагол.
- Отметьте предложения, где действует предмет или понятие: «стратегия помогает», «данные показывают». Подставьте того, кто действует на самом деле, или оставьте, если так короче и всё равно понятно.
- Замените сленговые глаголы и «провести оптимизацию» обычными глаголами.
- Проверьте метафоры: «бюджет внимания» и «трение» понятны вашему читателю или только вам?
- Вычеркните штампы по стоп-листу.
- Сверьте каждую цифру, имя и ссылку с источником.
- Добавьте то, чего нейросеть знать не может: цену, срок, случай клиента, ваш вывод.
Для короткой заметки в соцсети хватит первого, пятого и девятого пунктов. Статью на сайт или коммерческое предложение лучше пройти по всему списку.
Бесплатный мастер-класс · онлайнХотите, чтобы нейросеть сразу писала тексты вашим голосом? На вебинаре показываем, как настроить промты и проверку под ваш бизнес.
Записаться бесплатно →Частые вопросы
Как понять, что текст написала нейросеть?
Точно понять нельзя, можно только заподозрить. Подозрение вызывают слова-штампы и то, как построены предложения: неживые предметы, которые «говорят» и «съедают», цепочки существительных, подлежащее далеко от сказуемого. Чем больше таких примет в одном абзаце и чем больше в нём непроверенных цифр, тем вероятнее, что текст писала нейросеть и его никто не правил.
Есть ли эти признаки в текстах на русском языке?
Похожие — да, хотя исследование NYU и UT Austin сделано только на английском. В русском те же приёмы выглядят по-своему: длинные цепочки слов в родительном падеже, нагромождение причастных оборотов, «данные говорят», «рынок не прощает». Проверять русские тексты по шести признакам можно, но цифры исследования к ним напрямую не переносятся.
Почему новые нейросети пишут сложнее старых?
По гипотезе авторов исследования, причина в том, на чём модели доучивают. Их всё больше тренируют на задачах по математике и программированию, где поощряют за верный ответ, а понятность текста никто не оценивает. Так модель привыкает упаковывать мысль плотнее. Claude Opus 5.5 уже реже использует трудные обороты, чем Opus 5, и авторы пишут, что модели можно поощрять и за понятный текст.
Где проверить текст на ИИ бесплатно?
Бесплатно проверяют GPTZero, ZeroGPT и другие детекторы, но их процент не доказательство: детекторы принимают текст человека за машинный и наоборот. Надёжнее прочитать текст по шести признакам и сверить факты и ссылки. Почему детекторы ошибаются, мы подробно разобрали в статье о текстах от ИИ и поиске.
Источники
Пишет о нейросетях и продвижении в них для предпринимателей и маркетологов. Каждый гайд проверяет руками, цены сверяет по официальным страницам.